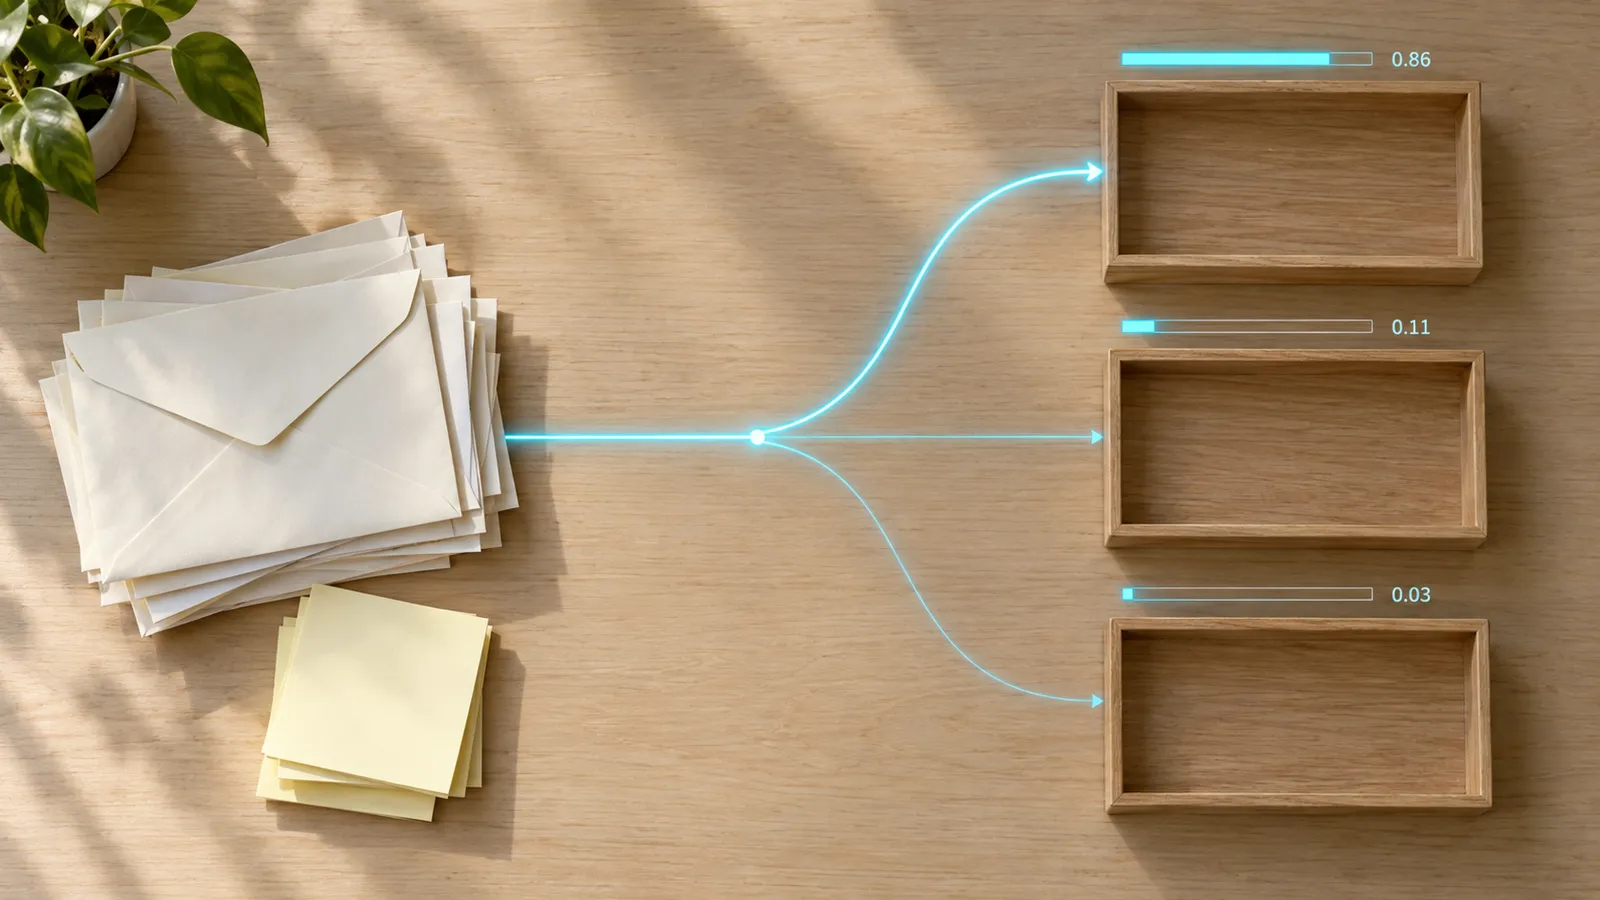
9월 중순에 좀 색다른 AI 모델이 하나 나왔습니다. 이름은 Jev입니다. 우리가 흔히 쓰는 LLM은 질문을 받으면 글을 한 글자씩 이어 써서 답합니다. Jev는 글을 쓰지 않습니다. 미리 정해 둔 보기 중에서 하나를 고르고, 그 답의 신뢰도를 숫자로 돌려줍니다. 답은 "환불 문의, 신뢰도 0.86" 같은 모양입니다.
소개 글을 보면서 이걸 어디에 쓸 수 있을지부터 떠올려 봤습니다. 들어온 고객 메일을 환불·배송·결제 담당으로 나누는 일, 댓글이 스팸인지 가려내는 일, 이 요청을 사람에게 넘길지 정하는 일. 프로그램 안에서 AI에게 맡기는 판단 중에는 이렇게 답이 정해져 있는 것이 꽤 많습니다. 이런 데에는 긴 문장이 필요 없습니다. 답 하나와 그 답을 얼마나 믿어도 되는지 알려 주는 숫자 하나면 됩니다.
그리고 한 가지 생각이 더 들었습니다. 출력이 이만큼 단순하다면, 꼭 큰 모델이 아니어도 되지 않을까요? 작은 모델을 가볍게 파인튜닝해서 한 가지 판단만 맡기면 충분할 것 같았습니다. 그 정도로 작다면 서버 없이 방문자의 브라우저 안에서도 돌릴 수 있습니다. MEGAFIXEL은 서버가 없는 블로그라서, 되기만 한다면 글 안에 바로 넣어 볼 수 있습니다.
Jev가 하는 일
Jev는 TypeSafe(새 탭에서 열림)라는 회사가 2026년 9월 15일에 내놓은 모델입니다. 이름은 경제학자 윌리엄 스탠리 제번스(William Stanley Jevons)에서 따왔다고 합니다. 회사는 이런 모델을 System One Model이라고 부릅니다. 빠르고 직관적인 생각(시스템 1)과 느리고 따지는 생각(시스템 2)을 나누는 심리학의 구분을 떠올리게 하는 이름입니다. 글을 길게 쓰며 따지는 보통 AI가 시스템 2라면, Jev는 보자마자 고르는 쪽입니다.
쓰는 방법은 간단합니다. 상황을 설명하는 글 한 덩어리(state)와, 답이 정해진 질문(questions)을 함께 보냅니다. 질문은 세 가지 모양이 있습니다.
| 질문 모양 | 하는 일 | 예 |
|---|---|---|
| choice | 보기 중 하나 고르기(보기 최대 255개) | 이 문의는 반품·배송·결제 중 어느 팀이 맡을까 |
| score | 정해진 단계 중 하나로 점수 매기기(2~10단계) | 급한 정도를 5단계로 |
| noul | 예일 확률 | 급하다는 느낌이 드나 |
공식 문서의 예시를 그대로 옮기면, "도와주세요! 정산이 3일째 실패하고 있어요."라는 글에 "급하다는 느낌이 드나?"를 물으면 이렇게 답합니다.
{
  "state": "Help! My payouts have been failing for 3 days.",
  "model": "jev-latest",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }
  }
}
{
"model": "jev-1.13.0",
"answers": { "is_urgent": { "type": "noul", "noul": 0.95 } },
"usage": { "input_tokens": 296, "output_tokens": 20 }
}답은 0.95, 급할 확률이 95%라는 숫자 하나입니다. 보기 고르기(choice)라면 고른 보기와 함께 보기마다 확률이 따라옵니다.
회사는 이런 일에서 큰 언어 모델보다 193.6배 빠르고 444.6배 싸다고 홈페이지에 적었습니다(System One 형태 작업 묶음 기준). 출시 글에서는 40~200배 빠르다고 조금 낮춰 말합니다. 홈페이지에 함께 실린 데모 한 건은 아래처럼 8.57초 대 0.11초입니다. 입력 100만 토큰에 0.042달러, 출력은 무료입니다. 다만 속도와 비용 배수는 모두 회사가 직접 잰 숫자이고, 아직 다른 곳에서 다시 재 본 결과는 찾지 못했습니다. 문서에는 영어가 주력이고 다른 언어는 지원하지만 덜 정확하다고 적혀 있습니다. 한국어로 쓰려는 입장에서는 눈여겨볼 대목입니다.
내 브라우저에서 돌릴 수 있을까
Jev 자체는 안 됩니다. 공식 문서는 API로 쓰는 방법만 안내하고, 내려받을 수 있는 모델 파일(가중치)은 없습니다. TypeSafe 서버에 물어보는 수밖에 없는데, 서버가 없는 이 블로그에서 브라우저가 직접 API를 부르면 API 키가 방문자에게 그대로 보이니 그것도 못 합니다.
대신 Jev가 나오고 한두 주 사이에 "Jev처럼 동작하는" 공개 모델들이 여럿 나왔습니다. 모두 TypeSafe와는 관계없는 프로젝트입니다.
| 이름 | 만든 방식 | 크기 | 라이선스 | 브라우저 |
|---|---|---|---|---|
| SemIf(새 탭에서 열림) (옛 이름 OpenJev) | 작은 언어 모델이 보기마다 매기는 점수를 바로 확률로 바꿈 | 0.6B~4B | MIT | 데모 있음 (639MB부터) |
| Laya(새 탭에서 열림) | 처음부터 고르기 전용으로 만든 인코더 모델, 100개 넘는 언어 | 다국어판 322M | Apache-2.0 | 변환본 있음 (326~574MB) |
| JevK5(새 탭에서 열림) | 4B 언어 모델에 Jev식 답을 추가로 학습 | 4B | Apache-2.0 | 없음, 영어 전용 |
| Kev(새 탭에서 열림) | 언어 모델에 작은 어댑터와 고르기용 머리를 얹음, Jev API와 같은 모양 | 0.8B~27B | Apache-2.0 | 없음 |
4B짜리는 받는 파일만 몇 GB라 블로그 방문자에게 받으라고 하기는 어렵습니다. 그래서 브라우저에서 돌아가는 Jev형 모델인 Laya를 중심으로, 일반 모델을 Jev처럼 쓰는 방법 몇 가지를 함께 재 보기로 했습니다.
다섯 모델 재 보기
Jev처럼 처음부터 고르기 전용으로 만든 모델 가운데 브라우저에서 돌아가는 건 Laya뿐이었습니다. 그래서 Laya 두 판에, 일반 모델에 Jev식 방법을 씌운 세 가지를 더해 다섯 개를 쟀습니다. 일반 모델은 글을 쓰거나 문장을 숫자로 바꾸는 모델이라, 보기마다 점수를 매겨 확률로 바꾸는 식으로 Jev 흉내를 냈습니다.
시험 문항은 한국어 24개, 같은 내용을 영어로 옮긴 24개입니다. 고객 문의 분류, 일정이 밀릴지 판단, 게임 캐릭터의 다음 행동 고르기, 쇼핑 리뷰의 감정, 예/아니오 질문을 섞었습니다. 맥 미니(M1)의 크롬에서 모델을 실제로 받아 돌렸습니다.
| 모델 | 종류 | 받는 용량 | 첫 로딩 | 문항당 | 한국어 | 영어 |
|---|---|---|---|---|---|---|
| multilingual-e5-small(새 탭에서 열림) | 일반 모델(문장 뜻 비교) | 135MB | 15초 | 0.2초 | 50% | 58% |
| mDeBERTa-v3 xnli(새 탭에서 열림) | 일반 모델(문장 관계 판단) | 334MB | 30초 | 0.8초 | 58% | 63% |
| Qwen3-0.6B(새 탭에서 열림) | 일반 언어 모델(SemIf 방식) | 579MB | 53초 | 0.3초* | 50% | 79% |
| Laya 다국어 기본판(새 탭에서 열림) | Jev형 | 360MB | 35초 | 0.6초 | 46% | 67% |
| Laya 다국어 다듬은 판(새 탭에서 열림) | Jev형(추가 학습) | 574MB | 57초 | 0.7초 | 67% | 67% |
* 그래픽 가속(WebGPU)을 썼을 때입니다. 가속 없이는 4.5초가 걸렸습니다.
결과는 좀 실망스러웠습니다. 한국어에서는 대부분 동전 던지기 수준입니다. "회의를 다음 주로 미루자"를 '취소'로 고르고, "또 살 거예요"를 '중립'으로 고르고, 뉴스레터에 "답장이 필요한가"를 물으면 '예'라고 확신합니다.
눈에 띈 건 Laya의 두 판입니다. 기본판은 한국어 46%였는데, 다른 개발자가 Jev식 결정 데이터로 추가 학습해 올려 둔 판은 67%였습니다. 그 데이터는 영어였는데도 한국어 점수가 올랐습니다. 그렇다면 내 일에 맞는 한국어 데이터로 직접 학습시키면 어떨까요.
범위를 좁히기
그래서 무엇이든 판단하는 범용 모델 대신, 한 가지 판단만 잘하는 판정기를 만들기로 했습니다. 첫머리에서 생각한 그대로, Jev형 모델 Laya를 그 판단 하나에 맞게 파인튜닝합니다.
시작점은 Laya 다국어 기본판입니다. 다듬은 판이 점수는 더 좋았지만 브라우저용 파일만 공개돼 있어서 이어서 학습할 수 없습니다. 기본판은 학습용 원본 파일과 공식 학습 도구가 함께 공개돼 있습니다.
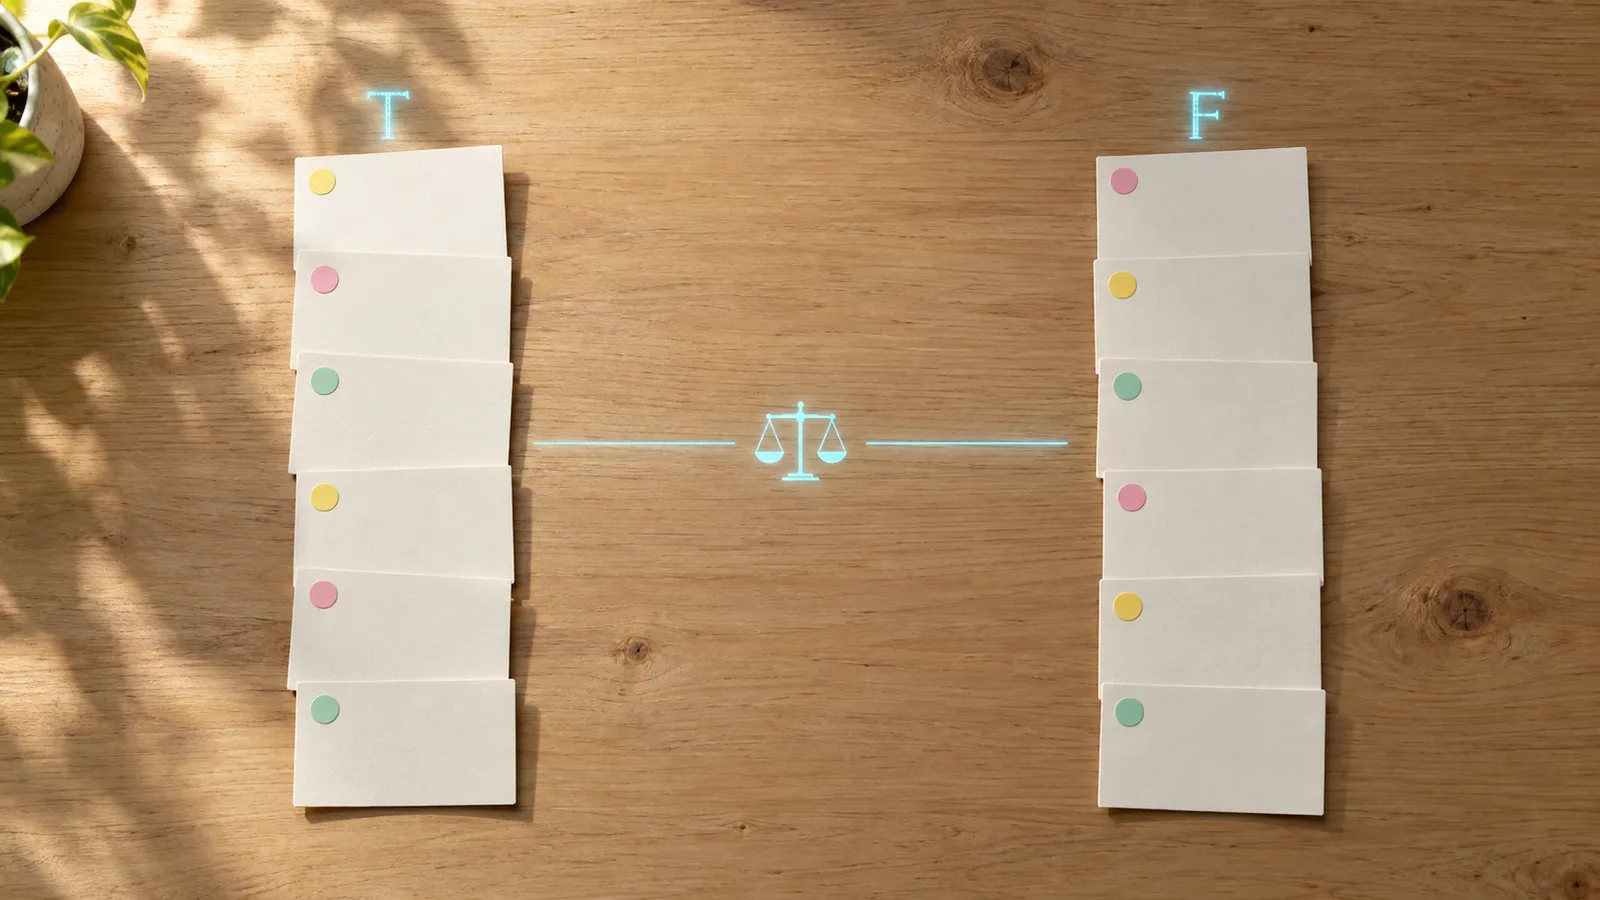
무엇을 판정할지는 조금 재미있는 걸로 골랐습니다. T/F 말투 판정기입니다.
친구가 "나 면접 또 떨어졌어"라고 했을 때 "어느 단계에서 떨어졌어? 서류부터 다시 보자"라고 답하는 사람이 있고, "많이 속상했겠다. 오늘은 아무 생각 하지 마"라고 답하는 사람이 있습니다. 앞의 대답은 일을 풀려고 하고, 뒤의 대답은 사람을 봅니다. MBTI 이야기를 좀 해 본 분이라면 "너 T야?"가 떠오를 겁니다.
이건 성격 검사가 아닙니다. 사람을 판정하는 게 아니라 그 대답 하나가 어디에 초점을 두는지를 판정합니다. 기준은 이렇게 정했습니다.
- T: 사건을 향한 말. 원인, 사실, 해결책, 판단, 다음에 할 일.
- F: 사람을 향한 말. 마음, 관계, 상태, 위로.
- 감정 단어가 들어 있다고 F가 되지는 않습니다. "속상하겠다. 일단 사진 찍고 보험사부터 불러"는 T입니다.
- 한쪽이 글자 수로 70% 이상이고 마지막 말도 그쪽일 때만 데이터로 씁니다. 반반인 대답은 버립니다.
Laya에 묻는 모양은 Jev와 같습니다. 상황과 대답을 state로 넣고, 보기 두 개짜리 choice 질문을 하나 붙입니다.
{
  "state": "상황: 친구가 “나 면접 또 떨어졌어…”라고 했다. 뭐라고 답할까?\n대답: 어느 단계에서 떨어졌어? 서류부터 다시 보자.",
  "questions": {
    "focus": {
      "type": "choice",
      "instructions": "이 대답은 어디에 초점을 두나?",
      "criteria": {
        "사건·해결(T)": "원인·사실·해결책·다음 할 일",
        "마음·관계(F)": "감정·공감·관계·상대의 상태"
      }
    }
  }
}
데이터 만들기
판정기를 학습하려면 "이 대답은 T, 이 대답은 F"라고 표시된 예가 많이 필요합니다. 사람 대답을 수천 개 모을 수는 없어서, AI에게 쓰게 했습니다.
먼저 상황 48개를 만들었습니다. 친구, 연인, 가족, 직장과 학교, 일상 사고, 축하할 일, 부탁과 갈등까지 일곱 갈래입니다. 이 중 36개는 학습에, 12개는 시험에만 씁니다. 시험 상황은 학습 때 한 번도 보여 주지 않습니다. 처음 보는 상황에서도 통하는지 보려는 겁니다.
그다음 상황마다 T 대답과 F 대답을 썼습니다. 학습용 2,160개, 시험용 240개입니다. 여기서 제일 신경 쓴 건 겉모양으로 답이 새지 않게 하는 것이었습니다. F 대답에만 "ㅠㅠ"가 붙고 T 대답만 존댓말이면, 판정기는 초점이 아니라 이모티콘을 배웁니다. 그래서 T와 F 양쪽에 반말과 존댓말, 이모티콘, 질문형, 짧은 말과 긴 말을 같은 비율로 섞었습니다. 다정하게 해결책을 권하는 T, 짧고 담백하게 위로하는 F도 일부러 넣었습니다.
라벨은 쓴 AI와 다른 AI가 다시 봤습니다. 라벨을 가린 채 대답만 읽고 T인지 F인지 판정한 뒤 원래 라벨과 맞춰 봤습니다. 학습 데이터에서 뽑은 216개 중 T와 F가 뒤집힌 건 0개였고, 애매해서 빼야 할 것이 8개였습니다. 시험 데이터 240개는 전부 봤고, 239개가 맞았습니다.
학습은 집에 있는 GPU 서버(RTX 3090)에서 Laya 공식 학습 도구로 했습니다. 학습 상황 중 4개는 따로 떼어 확률을 보정(calibration)하는 데만 썼고, 나머지 1,914개로 네 바퀴를 돌았습니다. 걸린 시간은 2분 남짓입니다. 보기 순서가 답을 흘리지 않게, 학습 때는 T와 F 보기의 순서를 매번 섞었습니다.
결과
여기까지가 1차 판정기입니다. 학습 전과 후를 같은 시험지로 쟀습니다. 시험지는 둘입니다. 처음 보는 상황 12개의 239문항, 그리고 단서를 일부러 반대로 건 반례 59문항입니다.
반례가 필요한 이유가 있습니다. 데이터를 보니 '마음'이라는 단어가 F 대답에 722번, T 대답에 12번 나왔습니다. '알려 줘'의 '알려'는 T에만 142번 나왔습니다. 이모티콘과 존댓말은 맞췄는데 단어는 맞추지 못한 겁니다. 이러면 판정기가 "'마음'이 있으면 F" 같은 지름길을 배울 수 있습니다. 그래서 '마음'이 들어 있는데 해결책만 말하는 T, '일단'이나 '알려'가 들어 있는데 위로만 하는 F 같은 대답을 따로 모았습니다. 지름길을 배웠다면 여기서 넘어집니다.
학습 전 Laya는 동전 던지기에 가까웠고, 반례에서는 그보다 못했습니다. 2분 학습한 뒤에는 시험 96.7%, 반례 96.6%로 처음 보는 상황에서도 열에 아홉 넘게 맞힙니다. 확률도 잘 맞아서, 판정기가 90%라고 하면 실제로 열에 아홉은 맞았습니다.
| 반례 유형 | 문항 | 학습 전 | 학습 후 |
|---|---|---|---|
| '마음'이 든 T | 12 | 16.7% | 100% |
| 감정 표현이 중간에 끼어 있는 T | 12 | 16.7% | 100% |
| 감정으로 시작하는 짧은 T | 12 | 16.7% | 100% |
| '일단·알려·부터·같이'가 든 F | 12 | 91.7% | 91.7% |
| 'ㅋ'이 든 F | 11 | 72.7% | 90.9% |
학습 전 Laya는 감정 단어가 보이기만 하면 F로 기울었습니다. 학습 뒤에는 그 세 유형을 모두 맞혔습니다.
다만 크게 자랑할 결과는 아닙니다. 비교로 글자 조각만 세는 단순 모델(n-gram)도 같은 시험지로 재 봤는데, 시험 97.5%, 반례 94.9%로 처음 보는 상황에서는 오히려 조금 앞섰습니다. 그만큼 AI가 쓴 데이터는 단어만으로도 꽤 갈립니다. 반례에서는 Laya가 앞섰지만 59문항 중 한 문항 차이입니다. 참고로 다른 방식으로 만든 판정기(e5-small이 문장을 바꾼 숫자 위에 간단한 판정 층만 얹은 것)도 시험 96.2%, 반례 100%로 비슷했습니다. 이 데이터만으로는 어느 쪽이 확실히 낫다고 말하기 어렵습니다.
남은 오답은 대부분 사실이나 약속이 한 구절 섞인 F였습니다. "그 회사 진짜 오래 다녔잖아. 지칠 만도 해. 아빠가 정말 하고 싶은 거라면 나는 어떤 결정이든 믿고 따를게."는 F인데, T로 99% 확신했습니다. '결정'과 '따를게'가 일을 정하는 말처럼 읽힌 것 같습니다.
보기 순서의 흔적도 조금 남았습니다. 데모는 보기를 T, F 순서로 고정해서 묻는데, 애매한 대답 몇 개는 순서를 바꾸면 판정이 뒤집혔습니다. 두 순서로 한 번씩 물어 평균하면 시험 97.1%, 반례 98.3%까지 오르지만, 판정 시간이 두 배가 돼서 데모에는 넣지 않았습니다.
차가운 말은 F로 봤다
1차 판정기를 데모에 붙이고 직접 써 봤습니다. 면접에 떨어졌다는 친구에게 "뭘 어떻게 하라는거지? 마음은 아프겠지만 나랑은 상관없어."라고 답해 봤더니, 판정은 F 99.6%였습니다.
사람들이 "너 T야?"라고 할 때 떠올리는 건 바로 이런 말입니다. 공감하지 않고, 선을 긋고, 냉정하게 따지는 말이요. 그런데 판정기는 이걸 마음을 챙기는 말로 봤습니다. 이유를 찾아보니 문제는 모델보다 기준과 데이터에 있었습니다.
- 기준이 T를 '사건을 푸는 말'로만 정의했습니다. 이 문장에는 해결책이 없고, '마음'과 '나랑은 상관없어'라는 관계 이야기만 있습니다.
- 데이터의 T는 거의 다 해결책을 권하는 말이었고, F는 거의 다 다정한 공감이었습니다. 공감을 거절하거나 선을 긋는 대답은 어느 쪽에도 없었습니다.
그래서 기준을 다시 세웠습니다. 판정 축을 상대의 마음에 다가가는가로 바꿨습니다.
- T: 일을 풀려는 말, 그리고 거리를 두는 말. 냉정한 판단, 선 긋기, 공감 대신 사실 짚기, 무심한 반응까지 포함합니다.
- F: 상대의 마음에 다가가는 말. 공감, 위로, 편들기, 관계 챙기기.
- 감정 단어가 있어도 그 감정을 치워 두는 말이면 T입니다. "마음은 아프겠지만 나랑은 상관없어"가 그렇습니다.
같은 단어가 양쪽에 쓰일 수 있어서 경계 예시를 많이 정해 뒀습니다.
| T | F |
|---|---|
| 울어도 바뀌는 건 없어. 헤어진 건 헤어진 거야. | 울어도 돼. 바뀌는 건 없어도 마음은 가벼워질 거야. |
| 네 점수는 네 거니까 나랑은 상관없어. | 점수가 뭐든 상관없어. 네가 얼마나 버텼는지 내가 봤잖아. |
| 저도 요즘 힘들어서 남 일까지 받을 여유가 없어요. | 저도 요즘 힘들어서 그런지 그 말이 마음에 걸리네요. |
길이도 바꿨습니다. 데모에 사람들이 쓸 말은 메신저로 보내는 한두 마디일 테니, 5~50자 짧은 대답만으로 다시 학습하기로 했습니다. 1차 데이터에서 50자를 넘는 대답은 학습에서 뺐습니다.
새 기준으로 짧은 대답 1,152개를 더 만들었습니다. 차가운 T, 차가운 단어가 들어 있지만 위로하는 F, 5~20자짜리 아주 짧은 T와 F가 같은 수씩입니다. 이번에는 라벨뿐 아니라 "실제로 메신저로 보낼 법한 말인가"까지 전부 검수했는데, 18%가 빠졌습니다. 기준에 맞추려고 차가운 단어를 억지로 끼워 넣은 말, 짧은 대답 안에 공감과 해결이 섞인 말, 존댓말로 말한 동료에게 반말로 답한 말이 대부분이었습니다. 남은 944개에 1차 데이터의 짧은 대답 696개를 더해 1,640개로 다시 학습했습니다.
처음 다시 학습한 모델은 정확도는 좋았지만 틀린 답도 99%로 확신했습니다. 학습 설정 다섯 가지를 비교해서, 학습 데이터에서 떼어 둔 검증 구간의 확률이 가장 잘 맞는 쪽을 골랐습니다. Laya 학습 도구의 손실 함수(loss function)를 기본값에서 soft-ce로 바꾼 설정이었습니다.
| 짧은 시험지 (처음 보는 상황, 141문항) | 학습 전 | 1차 판정기 | 다시 학습 |
|---|---|---|---|
| 전체 | 53.2% | 72.3% | 91.5% |
| 차가운 T | 11.1% | 33.3% | 86.1% |
| 아주 짧은 T (5~20자) | 29.4% | 85.3% | 94.1% |
| 차가운 단어가 든 F | 86.1% | 86.1% | 97.2% |
| 아주 짧은 F (5~20자) | 85.7% | 85.7% | 88.6% |
1차 판정기가 놓치던 차가운 T를 이제 열에 아홉 가까이 잡아냅니다. 1차 시험지에서 50자 이하인 문항(72개)과 반례(12개)는 그대로 모두 맞혔습니다. 확률도 다시 맞아서, 틀린 판정은 대부분 80~90%대로 나옵니다.
처음 문제의 문장은 이제 데모의 면접 상황에서 T 79%입니다. 99.6% 확신하던 F에서 T로 넘어왔지만 아주 확신하지는 않습니다. 같은 문장을 상황 12개에 넣어 보면 9개에서 T였고, 이별한 친구 상황을 포함한 3개에서는 T 42~46%로 아슬아슬하게 F 쪽에 남았습니다. 판정기가 상황 설명도 함께 읽기 때문입니다.
브라우저에 올리기
학습한 모델은 브라우저가 읽을 수 있는 ONNX 파일로 바꾸고, 숫자 정밀도를 8비트로 줄였습니다(quantization, 양자화). 처음에는 Laya 공식 변환 도구를 그대로 썼는데, 파일이 925MB였고 원래 모델과 판정이 9문항 달랐습니다. 단어 사전 부분을 줄이지 않는 방식이었기 때문입니다. 줄이는 방식을 바꾸자 351MB가 됐고, 298문항 모두 원래 모델과 판정이 같았습니다. 브라우저에서 계산한 확률도 파이썬과 소수 다섯째 자리까지 같았습니다.
그래도 351MB는 블로그 방문자에게 받으라고 하기엔 무겁습니다. 파일을 들여다보니 모델의 61%가 단어 사전이었습니다. Laya는 100개 넘는 언어를 다루려고 25만 6천 개의 토큰을 갖고 있는데, 한국어 대답에는 그중 대부분이 한 번도 나오지 않습니다.
그래서 공개된 한국어 문장 모음(위키백과, 영화 리뷰, 뉴스 댓글, 챗봇 대화, 일상 발화)에서 실제로 쓰이는 토큰을 세어 3만 9천 개만 남겼습니다. 한글 음절, 자주 쓰는 영어 단어, 이모지는 빠짐없이 남기고, 사전에서 빠진 드문 단어는 더 잘게 쪼개 읽게 했습니다. 다시 학습한 건 없습니다. 사전과 거기 딸린 숫자표만 잘라 냈습니다.
| 줄이기 전 | 줄인 뒤 | |
|---|---|---|
| 모델 파일 | 351MB | 184MB |
| 토크나이저 | 15.4MB | 1.7MB |
| 시험·반례 298문항 | 판정과 확률 모두 같음 | |
| 고르는 데 쓰지 않은 한국어 4,500문장 | 97.7%가 똑같이 읽힘, 판정 99.96% 같음 |
판정이 달라진 건 4,500문장 중 2개였습니다. 아스키 그림 이모티콘이 들어간 댓글과, 드문 영어 단어가 섞인 위키백과 문장입니다. 대화체 문장은 거의 그대로 읽혔습니다.
모델은 제 Hugging Face 저장소 Dunde/laya-tf-judge(새 탭에서 열림)에 올려 두었습니다. 원본 Laya와 같은 Apache-2.0이고, 무엇을 바꿨는지 함께 적었습니다.
직접 플레이
상황을 고르고, 내가 할 대답을 메신저에 보내듯 짧게 써 보세요(5~50자). 5자를 넘기면 쓰는 대로 판정이 바뀝니다. 판정 한 번에 1초 남짓 걸려서, 쓰다가 잠깐 멈추면 저울이 따라 기웁니다.
처음 한 번은 모델 받기를 눌러 모델(약 186MB)을 받아야 합니다. 한 번 받으면 브라우저에 저장돼서 다음에는 바로 열립니다. 계산은 전부 이 페이지 안에서 일어나서, 쓴 대답은 어디로도 보내지 않습니다. 받는 동안 심심하지 않게 공 떨어뜨리기 놀이를 하나 넣어 두었습니다. 다 받으면 접히고, 다시 펼쳐서 이어 할 수 있습니다.
이 판정기는 테스트용으로 여기까지만 만든 것이라 완벽하지 않습니다. 처음 보는 상황에서 열에 아홉 정도 맞히는 수준이고, 이런 대답은 자주 틀립니다.
- 공감을 먼저 해 주고 선을 긋는 대답. 예: "많이 당황하셨겠지만 저도 지금은 가 볼 수가 없어요"는 T인데 F로 볼 때가 있습니다.
- 사실을 들어 위로하는 짧은 대답. 예: "말 못 한 거 다들 겪어 봤어~"는 F인데 T로 볼 때가 있습니다.
- 같은 대답이라도 상황이 바뀌면 판정이 달라질 수 있습니다.
- 비꼬는 말이나 반어. 예: "저런.. 시끄러우니 나가서 울어"는 귀찮다고 밀어내는 말이라 T여야 하는데, F 100%가 나옵니다. 학습 데이터에서 '울어'는 "울어도 돼" 같은 위로에만 나왔고, 비꼬는 말은 데이터에서 일부러 뺐기 때문에 겉뜻 그대로 위로로 읽습니다.
판정에 나오는 숫자는 정답이 아니라 판정기가 그만큼 확신한다는 뜻으로 봐 주세요.
친구 · 1 / 48
친구가 “나 면접 또 떨어졌어…”라고 했다. 뭐라고 답할까?
예시 넣어 보기
T--F
스크립트를 켜면 판정기를 쓸 수 있습니다.
해 볼 만한 것
- 같은 상황에 T식 대답과 F식 대답을 하나씩 써 보고 저울이 어느 쪽으로 기우는지 봅니다.
- "그래서 뭐?", "알아서 해."처럼 차갑게 답해 봅니다. 1차 판정기가 놓치던 말들입니다.
- "마음은 아프겠지만 나랑은 상관없어."를 여러 상황에 넣어 봅니다. 상황마다 확신이 달라집니다.
- 차가운 말투로 위로해 봅니다. "아무도 그렇게 안 봐. 끝. 그만 자책해."는 F여야 합니다.
- 비꼬는 말로 판정기를 속여 보세요. 겉으로는 다정한데 속뜻은 차가운 말일수록 잘 넘어갑니다.
데모버전 완료
이 판정기는 여기서 멈췄습니다. 테스트용 데모로는 충분하다고 봤고, 더 좋게 만들 방법은 보입니다.
- 사람이 쓴 대답 모으기: 데이터가 전부 AI가 쓴 문장이라, 실제 사람의 대답에서는 점수가 더 낮을 겁니다. 사람의 말은 훨씬 지저분하고 섞여 있습니다.
- 약한 유형 보강하기: 공감 뒤에 선을 긋는 T, 사실로 위로하는 F를 더 모아 학습하면 남은 오답의 대부분을 줄일 수 있습니다.
- 상황에 덜 흔들리게 하기: 지금은 같은 대답이라도 어떤 상황에 붙이느냐에 따라 판정이 갈릴 때가 있습니다. "마음은 아프겠지만 나랑은 상관없어"가 면접 상황에서는 T인데, 이별 상황에서는 F 쪽으로 기우는 식입니다. 학습에 쓴 상황이 36개뿐이라, 더 많은 상황에서 같은 말을 학습시키면 상황보다 말 자체를 보게 될 겁니다.
- 보기 순서를 바꿔 한 번 더 묻기: 판정기에는 T와 F 두 보기를 늘 같은 순서(T 먼저)로 묻는데, 애매한 대답은 먼저 나온 보기 쪽으로 살짝 기웁니다. 순서를 바꿔 한 번 더 묻고 두 답을 평균하면 정확도가 조금 오르지만, 판정 시간이 두 배가 됩니다.
다만 이 글에서 하고 싶었던 건 거기까지 가는 게 아니었습니다. 답과 확률만 돌려주는 AI라는 아이디어를, 서버 없이 방문자의 브라우저 안에서 어디까지 따라 할 수 있는지 보고 싶었습니다. 범용으로는 아직 무겁고 한국어가 약했지만, Jev형 모델을 한 가지 판단에 맞게 2분 학습시키니 브라우저에서 꽤 그럴듯하게 돌아갑니다.
다음에는 데스크톱 앱처럼 내 컴퓨터에 내려받아 쓸 수 있는 형태로도 한번 만들어 보고 싶습니다.
용어 설명
- System One Model: TypeSafe가 Jev를 부르는 이름. 글을 쓰지 않고 정해진 보기 중에서 답과 확률을 바로 내는 모델.
- state(상태): Jev나 Laya에 보내는 상황 설명 글 한 덩어리.
- token(토큰): 모델이 글을 읽을 때 자르는 단위. 글자 하나일 수도, 단어 하나일 수도 있습니다. 모델은 토큰마다 정해진 숫자표를 갖고 있습니다.
- choice: 보기 중 하나를 고르는 질문. 이 글의 T/F 판정이 보기 두 개짜리 choice입니다.
- fine-tuning(파인튜닝): 이미 학습된 모델을 내 일에 맞게 추가로 학습하는 것.
- loss function(손실 함수): 학습할 때 모델의 답이 정답과 얼마나 다른지 재는 식. 무엇을 기준으로 재느냐에 따라 모델이 확신을 배우는 방식이 달라집니다.
- calibration(보정): 모델이 말하는 확률이 실제로 맞는 비율과 같아지도록 맞추는 것. 90%라고 하면 열에 아홉은 맞게.
- zero-shot(영샷): 그 일을 따로 학습하지 않고 바로 시키는 것. 이 글의 '학습 전' 점수입니다.
- n-gram: 글을 두세 글자씩 잘라 센 조각. 뜻은 모르고 어떤 글자 조각이 자주 나오는지만 봅니다.
- embedding(임베딩): 문장을 숫자 묶음으로 바꾼 것. 뜻이 비슷한 문장은 비슷한 숫자가 됩니다.
- ONNX: 여러 실행 환경에서 같은 모델을 돌릴 수 있게 정한 모델 파일 형식. 브라우저에서는 onnxruntime-web으로 읽습니다.
- quantization(양자화): 모델 숫자의 정밀도를 낮춰 파일을 줄이는 것. 이 글의 모델은 8비트로 줄였습니다.
- WebAssembly(WASM): 브라우저에서 빠르게 도는 실행 형식. 이 글의 데모는 그래픽 가속(WebGPU) 대신 이걸로 계산합니다.
더 알아보기
Jev
- Introducing System One Models & Jev(새 탭에서 열림): TypeSafe 출시 글(2026-09-15)
- TypeSafe API 문서(새 탭에서 열림) · 모델과 가격(새 탭에서 열림) · System One 개념(새 탭에서 열림)
Jev처럼 동작하는 공개 모델
- SemIf(새 탭에서 열림): 작은 언어 모델의 보기 점수를 확률로 읽는 방식, 브라우저 데모 포함
- Laya(새 탭에서 열림) · Laya 다국어판(새 탭에서 열림) · 브라우저용 변환본 laya-web(새 탭에서 열림)
- JevK5(새 탭에서 열림) · Kev(새 탭에서 열림)
데모
- Dunde/laya-tf-judge(새 탭에서 열림): 이 글에서 학습한 T/F 판정 모델
- Laya GitHub(새 탭에서 열림): 공식 학습 도구(
laya.train.finetune)와 ONNX 변환 스크립트 - ONNX Runtime Web(새 탭에서 열림): 브라우저에서 ONNX 모델을 돌리는 라이브러리
- Transformers.js(새 탭에서 열림): 데모에서 토크나이저를 읽는 데 썼습니다
- multilingual-e5-small(새 탭에서 열림): 비교에 쓴 다국어 임베딩 모델
COMMENTS
댓글을 불러오고 있습니다.