일본어 공부를 시작하면서 단어장부터 만들었습니다. 시중 단어장도 많지만, 같은 한자를 쓰는 단어를 한눈에 보고 예문을 바로 들어 보고 한자의 획순까지 한 화면에서 보고 싶었습니다. 그렇게 모은 것이 Study(새 탭에서 열림)의 N5 단어장입니다.
이번에도 코드와 데이터는 AI가 만들고, 저는 무엇을 넣을지 정하고 결과를 검토했습니다.
단어 목록 합치기
JLPT는 2010년 개편 뒤로 급별 공식 단어 목록을 내지 않습니다. 대신 학습자들이 기출과 교재를 바탕으로 정리한 목록이 여럿 돌아다니는데, 목록마다 들어 있는 단어가 조금씩 다릅니다.
그래서 AI에게 여러 곳의 자료를 찾아 참고하게 하고, 그걸 바탕으로 N5 단어 목록을 새로 만들었습니다. N5로 보기 어려운 단어는 N4로 넘겼습니다. 나중에 한자 묶음을 만들면서 '해'나 '날'이라는 뜻의 日(ひ)가 빠진 것을 알았습니다. N4로 보는 단어지만 日이 들어간 N5 단어가 많아서 N4 꼬리표를 달고 넣었습니다. 지금은 721개입니다.
뜻과 예문
단어마다 품사, 뜻, 예문, 예문 해석, 난이도(상·중·하)를 붙였습니다. 721개 초안은 Codex가 쓰고, Claude가 처음부터 끝까지 검수했습니다. 같은 회사 모델끼리는 놓치는 부분도 비슷할 것 같아서 만든 회사가 다른 두 모델에 일부러 나눠 맡겼습니다. 검수에서 125군데를 고쳤습니다.
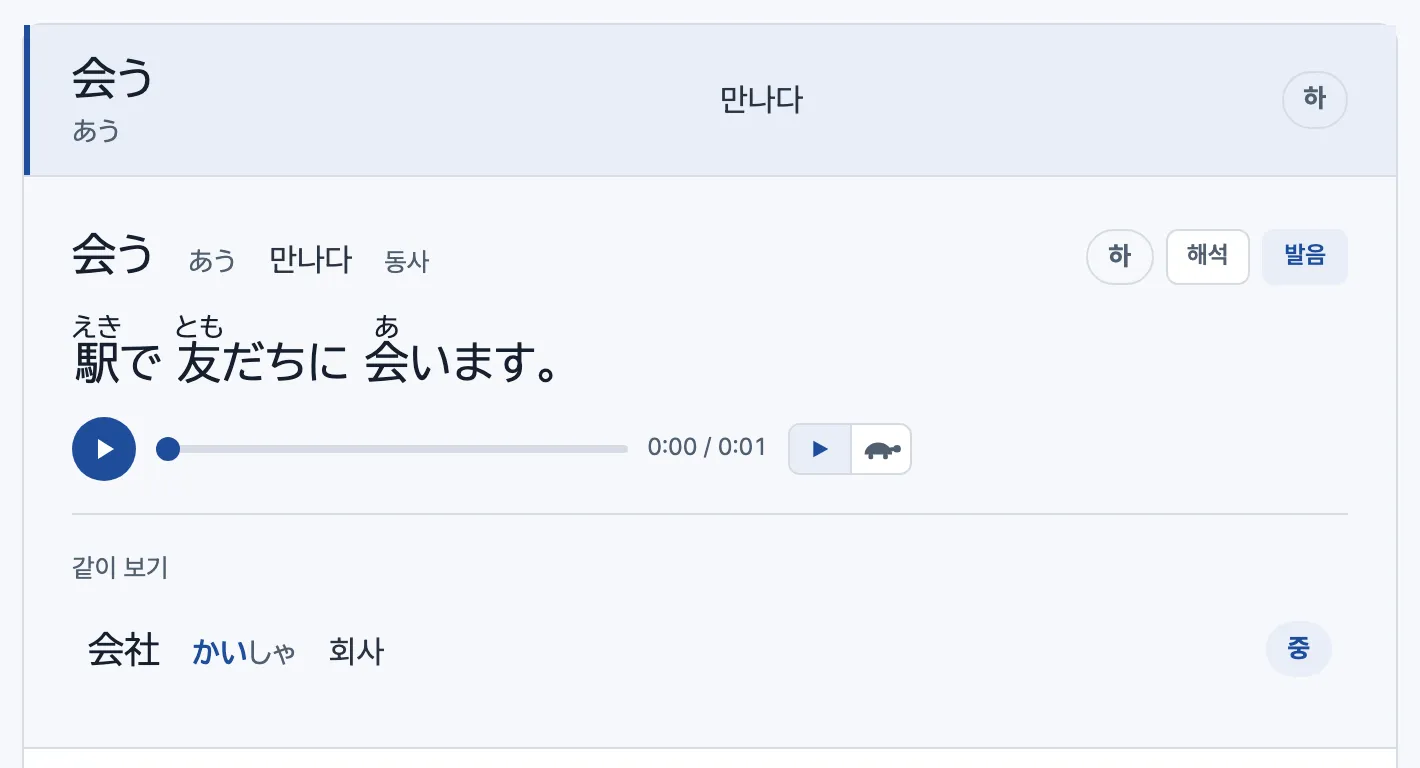
예문의 한자에는 후리가나를 달았습니다. 후리가나와 해석은 단어마다 따로 켜고 끌 수 있어서, 해석을 가리고 먼저 읽어 볼 수 있습니다.
같은 한자끼리 묶기
처음 만든 목록은 일본어 사전처럼 읽는 소리 순서였습니다. 그런데 이렇게 놓으면 青(あお, 파랑)과 青い(あおい, 파랗다)가 멀리 떨어집니다. 같은 한자를 쓰는 단어는 한 줄로 묶었습니다.
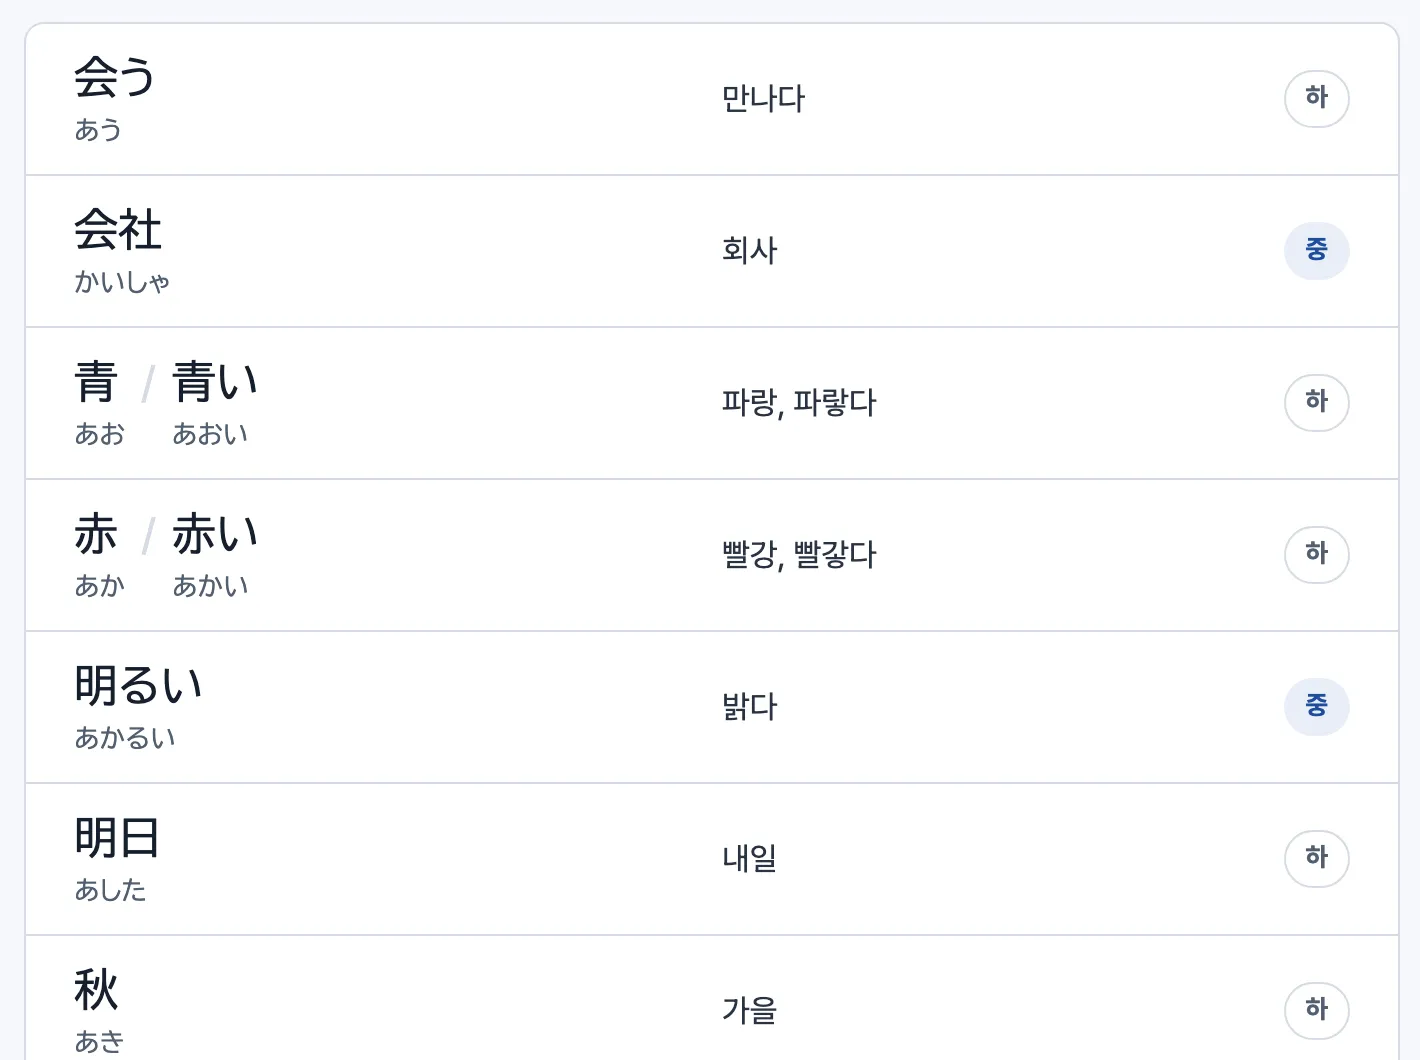
순서는 한자 한 글자짜리 묶음을 기준으로 두고, 그 한자가 들어간 합성어 묶음을 바로 뒤에 붙였습니다. 会う(あう, 만나다) 바로 뒤에 会社(かいしゃ, 회사)가 오는 식입니다. 한자가 없는 단어는 맨 뒤에 모았습니다.
묶음을 펼치면 '같이 보기'가 나옵니다. 그 한자가 다른 소리로 읽히는 합성어를 모은 칸입니다. 会う의 会는 '아'로 읽지만 会社에서는 '카이'로 읽습니다. 日처럼 읽는 법이 많은 한자는 같이 보기만 23개입니다.
예문 음성
예문 721개에 모두 음성을 붙였습니다. 음성 합성은 ElevenLabs를 썼습니다. 예문뿐 아니라 앞으로 청해와 회화 연습에 쓸 음성도 넉넉히 만들려고 유료 플랜(Starter)을 결제했습니다. 일본어 목소리 몇 개를 들어 보고 여성 한 명, 남성 한 명을 골라 예문마다 번갈아 읽게 했습니다.
만들고 나서 들어 보니 문장 첫소리가 잘리는 문제가 있었습니다. 暑いので(あついので, 더워서)가 '츠이노데'로 들렸습니다. 앞에 짧은 무음을 붙여도 그대로였고, 문장 맨 앞에 일본어 쉼표(、)를 하나 넣고 만들자 '아츠이노데'로 제대로 나왔습니다.
음성은 32kbps로 만들어 721개가 모두 9MB 정도입니다. 느리게 듣는 기능은 파일을 따로 만들지 않고 브라우저에서 재생 속도를 0.75배로 낮춥니다. 속도를 낮춰도 음 높이는 그대로입니다.
한자 획순
한자에 마우스를 1초 올려 두면 획순이 말풍선으로 나옵니다. 바로 뜨면 화면을 훑을 때마다 말풍선이 튀어나와서 1초를 기다리게 했고, 그동안 한자 뒤로 노란 바탕이 차오르게 해서 곧 뜬다는 것을 알 수 있게 했습니다. 휴대폰에서는 한자를 길게 누르면 됩니다.
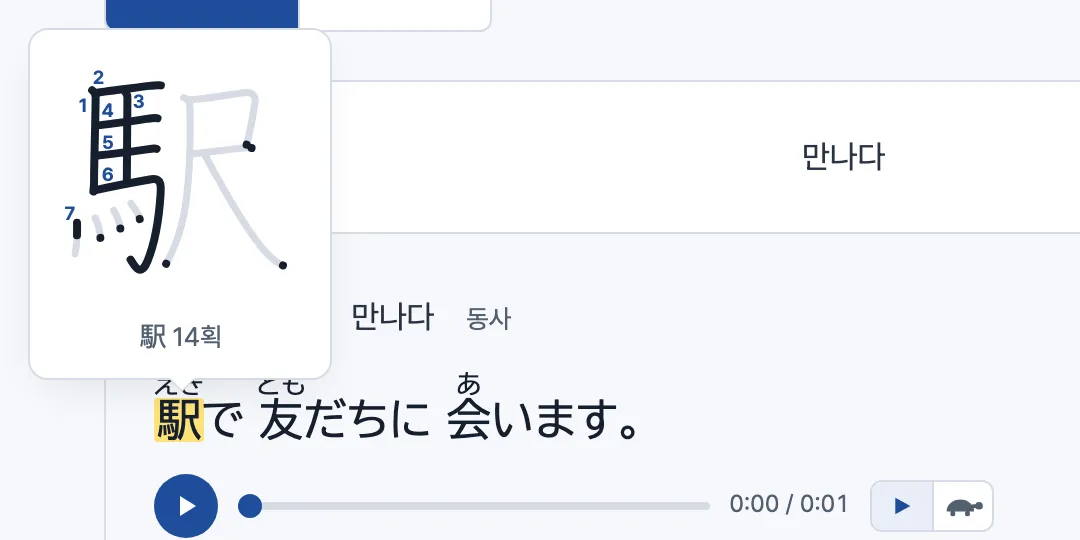
획순 데이터는 KanjiVG(새 탭에서 열림)를 씁니다. 한자마다 획을 순서대로 담은 공개 데이터라, 획을 하나씩 그려 나가는 애니메이션은 이 데이터로 직접 만들었습니다.
노트
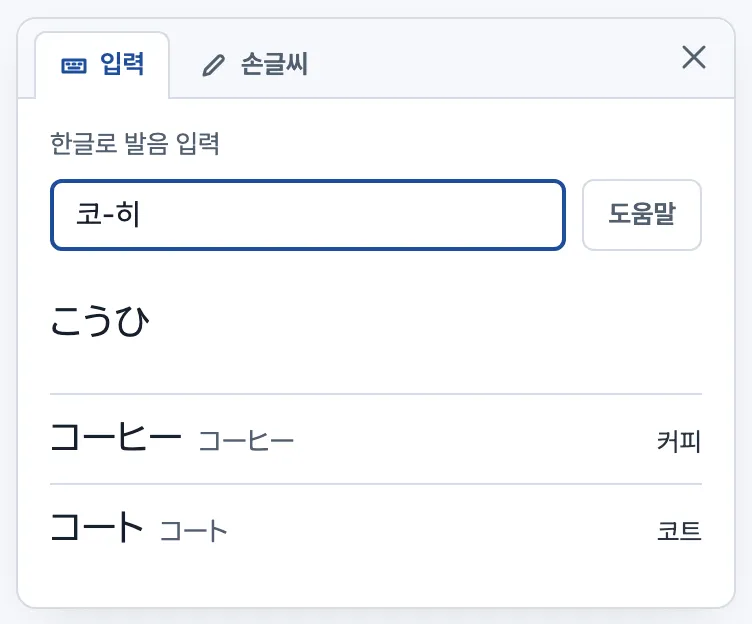
단어장을 보다가 모르는 단어를 찾을 수 있게 노트 창을 붙였습니다. 입력 칸에 한글로 발음을 쓰면 가나로 바꿔 주고 단어장에서 그 단어를 찾아 줍니다. 아소코를 치면 あそこ가, 코-히를 치면 コーヒー(커피)가 나옵니다. 길게 늘이는 소리는 하이픈으로 씁니다.
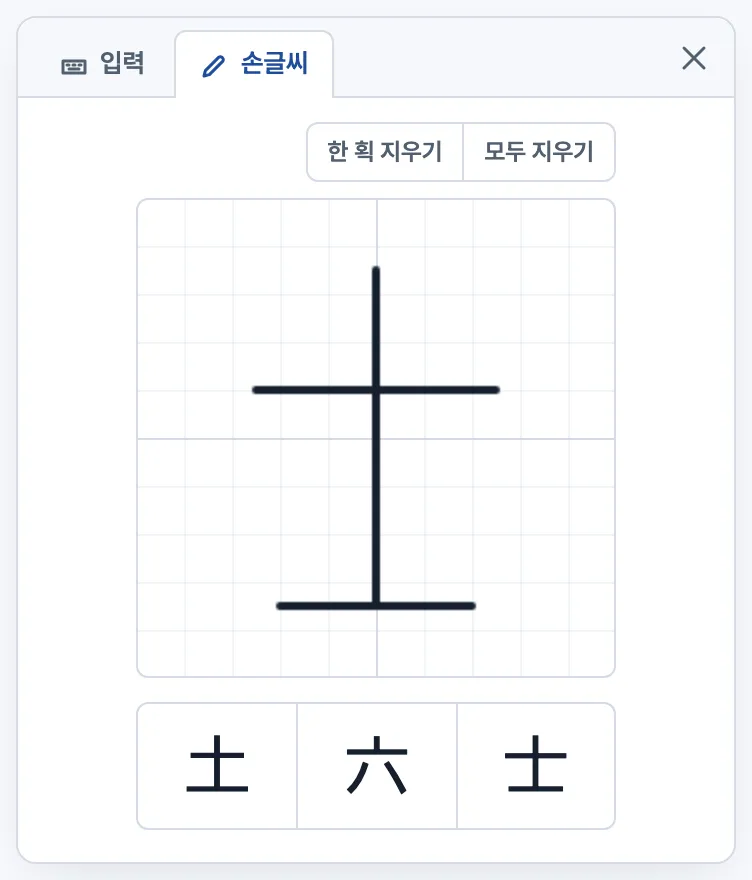
손글씨 칸에 한자를 그리면 비슷한 한자 후보가 나옵니다. 손글씨 인식은 KanjiCanvas(새 탭에서 열림)라는 공개 라이브러리입니다. 그린 획을 정답 패턴과 하나씩 맞춰 보는 방식이라 획 순서나 획 수가 틀리면 정답이 후보에서 밀립니다. 손글씨를 그림으로 알아보는 신경망 모델로 바꿀 수 있는지 알아보는 중입니다.
다음 자료
N5 단어 다음은 문법과 청해입니다. 청해는 두 사람이 주고받는 대화가 필요해서, 이번에 고른 두 목소리로 대화 음성을 만들어 볼 생각입니다. 연습 문제를 충분히 만들면 지금 레벨 테스트의 임시 문제 60개도 그 문제로 바꿉니다.
COMMENTS
댓글을 불러오고 있습니다.