

예전에 드론으로 서비스를 하는 회사에 다녔습니다. 입사할 때 제 직무는 분명히 프론트엔드였습니다. 사용자가 보는 화면을 만드는 사람이요.
그런데 일을 하다 보면 화면 말고도 꼭 필요한 일들이 생깁니다. 화면이 받아 쓸 API가 있어야 하고, 그 API가 돌아갈 서버가 있어야 하고, 서버가 붙을 사내 네트워크도 손봐야 합니다. 문제는 회사에 그걸 할 줄 아는 사람이 없었다는 겁니다. 다른 개발자들 중에도요. 필요한데 아무도 못 하면 결국 누군가는 해야 하고, 그게 저였습니다.
그렇게 API를 만들다 보니 백엔드를 하고 있었고, 서버를 세우다 보니 인프라를 하고 있었습니다. 연구용 GPU 서버를 사내에서 원격으로 쓸 수 있게 하고, 사내 NAS를 밖에서도 안전하게 들어올 수 있게 묶는 일까지 했습니다.
어느 순간부터는 제가 프론트엔드 개발자라는 사실을 저만 기억하는 것 같았습니다.
이것저것 다 하는 사람이 되고 나니, 일이 하나 더 왔습니다. 드론 회피 알고리즘 연구였습니다. 날아가던 드론 앞에 장애물이 나타나면 스스로 알아보고 피하게 만드는 일입니다. 화면에서 버튼을 어디에 둘지 고민하던 사람이, 하늘에서 드론이 나무를 어느 쪽으로 피할지 고민하게 된 셈입니다. 돌고 돌아 다시 픽셀을 들여다보게 된 것도 재미있었습니다. 이번에는 화면의 픽셀이 아니라 카메라에 찍힌 픽셀이었지만요.
다시 만들어 보기
회사를 나오고 시간이 지나니, 그때 쓰던 기술이 조금씩 흐려지는 게 느껴집니다. 자전거는 몇 년을 안 타도 탈 수 있다는데, 코드는 몇 달만 안 봐도 내가 짠 게 맞나 싶어집니다.
그래서 잊기 전에 한 번 다시 만들어 보려고 합니다. 다만 회사에서 만든 것을 그대로 옮겨 올 수는 없습니다. 그건 회사의 것이니까요. 대신 핵심 생각만 가져오고, 무대와 코드는 처음부터 새로 짭니다.
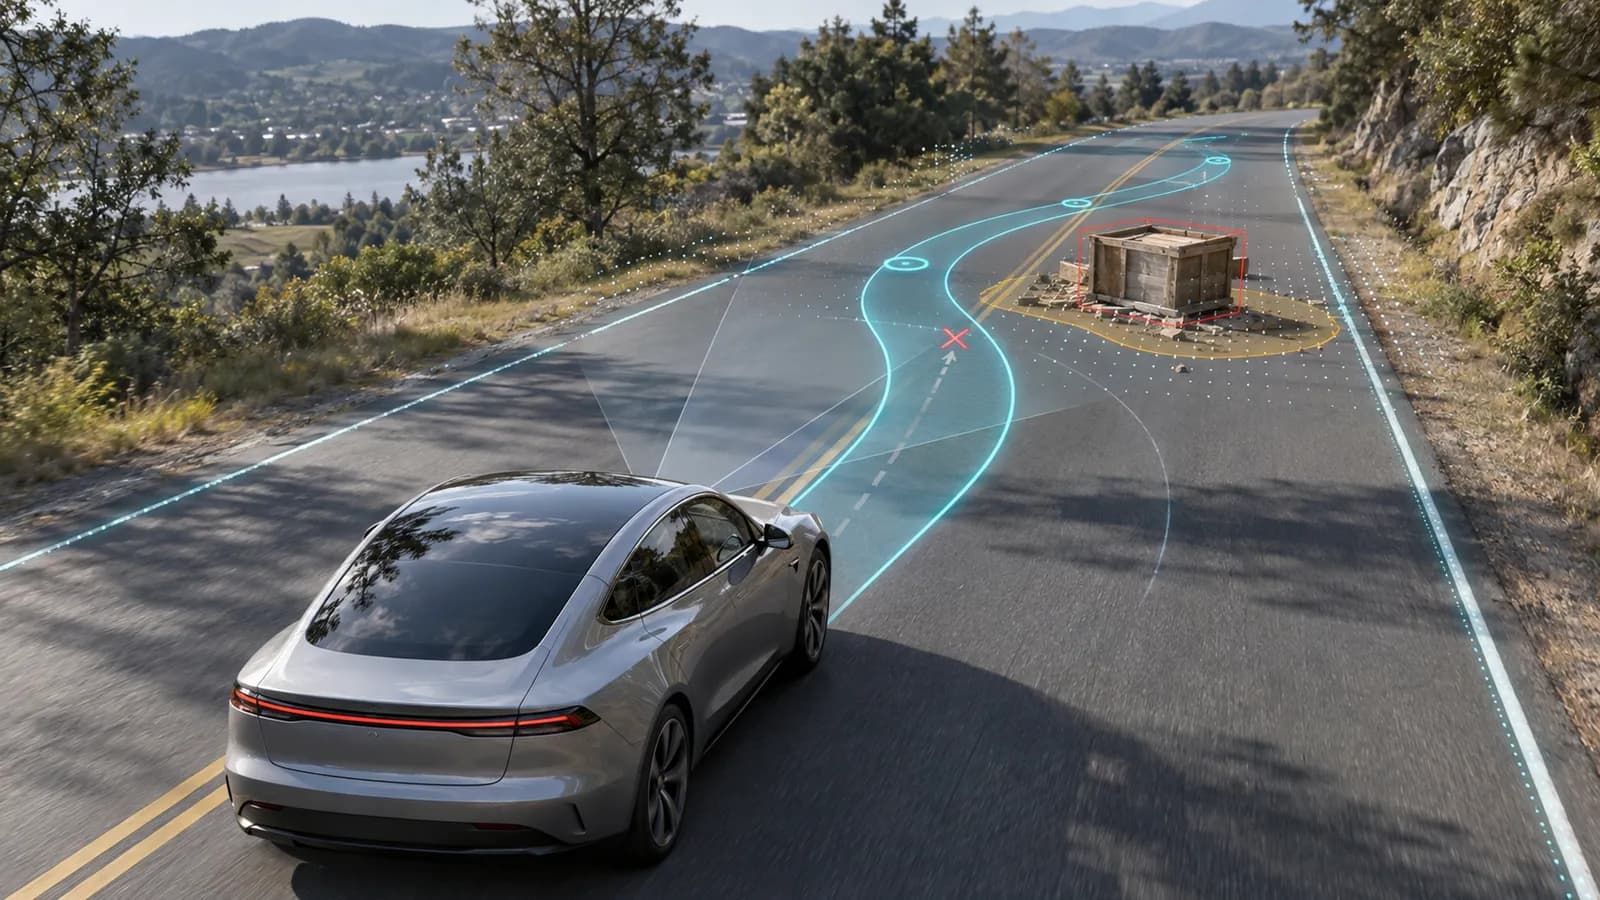
무대는 하늘 대신 도로, 드론 대신 자동차입니다. 드론은 위아래, 앞뒤, 좌우를 모두 움직여서 처음부터 다루기엔 변수가 너무 많습니다. 자동차는 앞으로 달리면서 좌우로만 피하면 됩니다. 문제를 한 겹 덜어 낸 대신, 장애물을 알아보는 방법은 그때와 같은 방향으로 가 보려고 합니다.
작업 계획
3D 도로를 달리는 자동차를 뒤에서 따라가며 보는 화면입니다. 앞에서는 장애물이 무작위로 나타나고, 자동차는 좌우로 움직이고 속도를 조절하면서, 최대한 많이 피하며 멀리 가야 합니다.
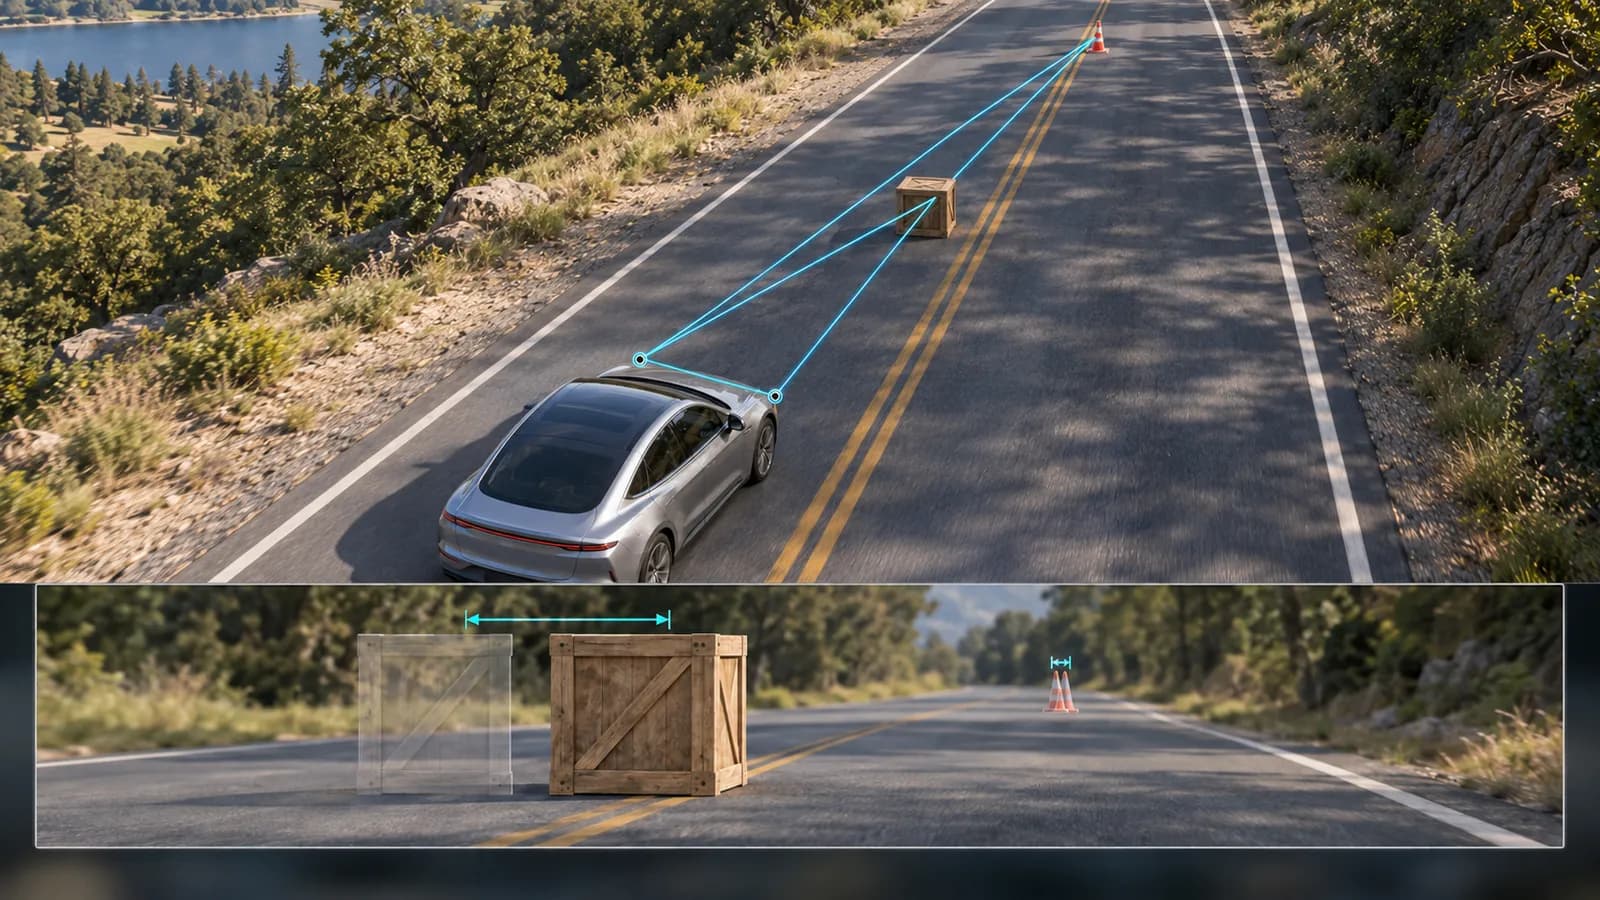
운전은 사람이 아니라 간단한 AI가 합니다. 그리고 이 AI는 우리가 보는 화면을 보지 못합니다. AI가 볼 수 있는 건 자동차 앞쪽 양옆에 달린, 정면을 바라보는 카메라 두 대의 영상뿐입니다. 사람이 두 눈으로 거리를 느끼듯, 두 영상이 서로 얼마나 어긋나 보이는지로 장애물까지의 거리를 계산합니다. 이걸 스테레오 뎁스(stereo depth)라고 합니다.
카메라만으로 거리를 읽는 방식은 실제 자동차에서도 쓰입니다. 대표가 테슬라입니다. 일론 머스크는 2019년 발표에서 LiDAR(라이다)를 두고 "바보짓(fool's errand)"이라고까지 했고, 테슬라는 2021년 5월 북미의 모델 3·Y부터 레이더를 뺐습니다. 2022년 10월부터는 초음파 센서도 빼기 시작했습니다. 이제는 차 둘레에 단 카메라들로 주변을 판단합니다.
다만 테슬라가 제가 하려는 스테레오 방식을 쓰는 건 아닙니다. 앞유리에 달린 카메라 세 대는 화각(field of view)이 서로 다른 렌즈라서, 같은 카메라 두 대를 나란히 놓고 두 영상의 어긋남을 재는 구조가 아닙니다. 테슬라는 여러 카메라의 영상을 신경망에 넣어, 주변 공간을 작은 칸으로 나누고 칸마다 무언가 있는지를 예측합니다. 2022년에 공개한 Occupancy Network입니다. 두 카메라 영상의 어긋남으로 거리를 재는 쪽은 오히려 스바루의 운전 보조 장치(첨단 운전자 보조 시스템, ADAS) EyeSight가 가깝습니다. 룸미러 옆에 카메라 두 대를 달아 앞길을 봅니다.
그래서 이 실험은 테슬라를 따라 하는 게 아니라, 카메라만으로 거리를 안다는 같은 문제를 신경망 대신 계산식으로 풀어 보는 쪽입니다. 그래도 닮은 점이 하나 있습니다. 공간을 작은 칸으로 나눠 장애물을 판단한다는 점입니다. 제가 쓰려는 복셀이 바로 그 칸입니다.
그때 써 본 방법들
회사에서는 거리를 재는 방법을 여러 가지 비교했습니다. 계산식으로 푸는 고전적인 방법부터, 학습한 신경망까지입니다.
| 방법 | 종류 | 그때 결과 |
|---|---|---|
| SGBM + WLS 필터 | 계산식 | 채택 |
| RAFT-Stereo | 신경망(스테레오) | 탈락 |
| CREStereo | 신경망(스테레오) | 탈락 |
| Depth Anything V2 | 신경망(카메라 한 대) | 회피용으로 부적합 |
- SGBM + WLS 필터: 계산식으로 disparity를 구하고 후처리 필터로 다듬는 고전적인 조합입니다. 이번 글의 주인공이라 아래에서 따로 설명합니다.
- RAFT-Stereo(2021): 움직임을 추적하던 optical flow(광류) 신경망 RAFT를 스테레오용으로 바꾼 모델입니다. 두 영상에서 뽑은 feature(특징)로 모든 disparity 후보의 correlation volume(상관 볼륨)을 만들어 두고, GRU가 disparity map(시차 지도)을 여러 번 반복해 고쳐 나갑니다. 정확도가 높고, 실시간용 가벼운 설정도 따로 있습니다.
- CREStereo(2022): coarse-to-fine, 즉 낮은 해상도에서 높은 해상도로 단계를 밟아 가며 반복해 다듬는 스테레오 신경망입니다. 두 카메라 영상의 줄 맞춤(정류, rectification)이 완벽하지 않은 실제 영상에서도 버티도록 correlation을 구하는 방식을 고친 것이 특징입니다.
- Depth Anything V2(2024): 카메라 두 대가 아니라 한 대의 영상만으로 깊이를 추정하는 모델입니다. 기본 모델은 relative depth(상대 깊이), 즉 무엇이 더 가깝고 먼지를 알려 주고, 미터 단위의 metric depth(절대 깊이)로 fine-tuning(미세조정)한 버전은 따로 나와 있습니다.
결과만 보면 신경망이 계산식을 이기지 못했습니다. 신경망 쪽은 좋은 GPU에서 빠르게 돌기는 했지만, 값싼 웹캠 영상에서는 가까운 것과 먼 것의 구분이 뭉개졌고, 추가로 학습시켜도 SGBM을 넘지 못했습니다. Depth Anything V2는 빠르고 그럴듯한 depth map(깊이 지도)을 냈지만, 무엇이 더 가까운지만 알려 줄 뿐 몇 미터인지는 알려 주지 않아서 피할 거리를 정하는 데 쓸 수 없었습니다.
신경망이 나빠서라기보다 조건의 문제였습니다. 카메라가 값싸고, 학습 데이터와 시간이 부족한 상황에서는 원리가 단순한 쪽이 더 믿을 만했습니다. 좋은 카메라와 충분한 데이터가 있었다면 결과는 달랐을 수 있습니다.
이번에는 같은 이유로 SGBM을 씁니다. 이 글의 모든 계산은 읽는 분의 브라우저에서 돌아야 하니, 무거운 신경망보다 계산식이 훨씬 가볍습니다.
| 그때(드론) | 이번(자동차) | |
|---|---|---|
| 카메라 | 실제 카메라 두 대 | 3D 장면 속 가상 카메라 두 대 |
| 거리 계산 | SGBM + WLS 필터 | SGBM 방식을 자바스크립트로(Web Worker) |
| 장애물 모으기 | 3D 복셀 | 같은 방식 |
| 피하기 | potential field, 3D VFH | potential field + 도로 벽 + 와류 |
| 계산하는 곳 | 서버, 드론 보드 | 브라우저 |
두 카메라로 거리 재기
손가락 하나를 눈앞에 세우고 왼쪽 눈과 오른쪽 눈을 번갈아 감아 보면, 손가락이 좌우로 크게 뛰어 보입니다. 멀리 있는 물체는 거의 움직이지 않습니다. 이렇게 두 시점에서 같은 물체가 어긋나 보이는 정도를 disparity(시차)라고 합니다. 가까울수록 disparity가 크고, 멀수록 작습니다.
두 카메라가 같은 방향을 보고 나란히 있으면, 거리는 간단한 식으로 나옵니다.
거리 = focal length(픽셀) × baseline ÷ disparity(픽셀)
focal length는 카메라의 초점 거리를 픽셀 단위로 나타낸 값이고, baseline은 두 카메라 사이 간격입니다.
문제는 왼쪽 영상의 한 점이 오른쪽 영상의 어디에 찍혔는지 찾는 일입니다. 이걸 stereo matching(스테레오 정합)이라고 합니다. 두 카메라가 나란하면 같은 점은 오른쪽 영상의 같은 줄 어딘가에 있으니, 한 줄만 옆으로 훑으면 됩니다.
SGBM(Semi-Global Block Matching)은 이 매칭을 푸는 대표적인 계산식입니다. 왼쪽 영상의 픽셀마다 오른쪽 영상의 같은 줄에서 작은 블록을 한 칸씩 옮겨 가며 비교해, disparity 후보마다 얼마나 다른지 점수(정합 비용, matching cost)를 매깁니다. 비용이 가장 낮은 후보만 고르면 잡음이 심하니, 이웃 픽셀과 disparity가 갑자기 튀면 페널티(penalty)를 더하면서 여러 방향의 직선 경로를 따라 비용을 모읍니다. 영상 전체를 한 번에 최적화(global)하는 대신 직선 몇 개로 나눠 풀어서 semi-global이라는 이름이 붙었습니다.
원래 방법인 SGM(Semi-Global Matching)은 비용으로 Mutual Information(상호정보량)을 쓰고 8방향 이상으로 비용을 모읍니다. 흔히 쓰는 OpenCV의 StereoSGBM은 여기서 조금 덜어 낸 변형입니다. 더 단순한 픽셀 비교(Birchfield–Tomasi)로 비용을 구하고, 기본 설정에서는 영상을 한 번만 훑어 5방향만 모읍니다. 8방향 전부를 쓰는 설정도 있지만 메모리를 많이 씁니다.
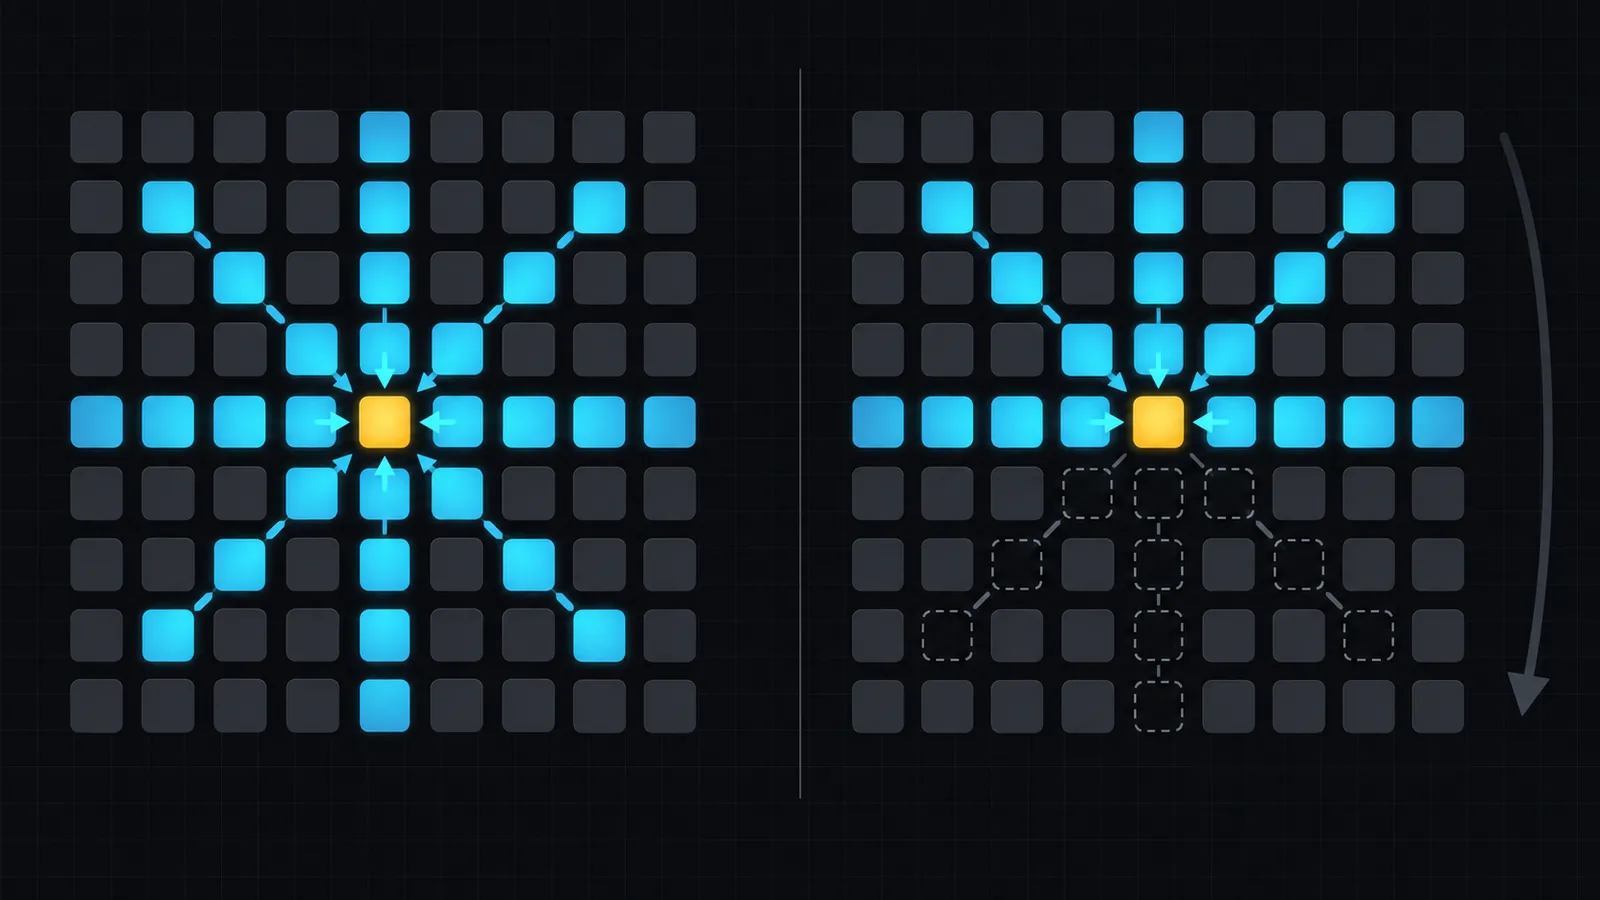
위에서 아래로 한 번만 훑어서 아래쪽 3방향이 빠진다.
그때는 SGBM 결과를 WLS 필터(Weighted Least Squares, 가중 최소제곱)로 한 번 더 다듬었습니다. 왼쪽 기준으로 구한 disparity와 오른쪽 기준으로 구한 disparity를 서로 대조해(좌우 일관성 검사, left-right consistency) 믿을 만한 곳과 아닌 곳을 가리고, 믿기 어려운 곳, 즉 한쪽 카메라에서 가려진 곳(폐색 영역, occlusion)과 민무늬인 곳(텍스처 없는 영역, textureless)은 원본 영상의 경계에 맞춰 주변의 믿을 만한 값으로 채우는 후처리입니다.
이번 데모에서는 가상 카메라 영상을 160×96(모바일은 120×72)으로 작게 찍고, disparity를 0~31 범위에서 찾습니다. 비용은 5×5 블록의 밝기 차를 절댓값으로 평균한 값(SAD)으로 구하고, OpenCV 기본 설정처럼 5방향으로 모읍니다. 한 번 계산하는 데 제 컴퓨터에서 12ms쯤 걸립니다. 화면을 그리는 흐름이 끊기지 않도록 이 계산은 Web Worker에서 따로 돌립니다.
WLS 필터처럼 빈 곳을 채우는 후처리는 넣지 않았습니다. 잘못 채운 값은 가짜 장애물이 되거나 진짜 장애물을 가릴 수 있어서, 이번에는 믿기 어려운 값을 버리고 비워 두는 쪽을 택했습니다. 버리는 검사는 세 가지입니다. 좌우 일관성 검사, 1등 후보와 2등 후보의 비용이 거의 같으면 버리는 검사(uniqueness ratio), 그리고 블록 안에 가로 방향 밝기 변화가 거의 없으면 버리는 검사(texture threshold)입니다. 마지막 검사는 OpenCV에서는 StereoSGBM이 아니라 더 단순한 StereoBM에 있는 단계입니다. 3D 엔진이 그린 영상은 잡음이 전혀 없어서, 이 검사가 없으면 SGM이 민무늬 면을 가장자리 값으로 그럴듯하게 채워 버립니다.
참고로 disparity를 31까지만 찾기 때문에 차 앞 6.4m 안쪽은 잴 수 없습니다. 뎁스 화면에서 차 바로 앞 도로가 검게 보이는 이유입니다.
이 방식에는 분명한 약점이 있습니다. 민무늬 면은 매칭할 단서가 없습니다. 하얀 벽이나 단색 상자는 왼쪽 영상의 한 블록이 오른쪽 줄의 어디와도 똑같아 보여서 disparity를 정할 수 없습니다. 데모의 옵션에서 장애물 표면을 민무늬로 바꾸고 카메라 비전을 뎁스로 보면, 상자 안쪽이 검게 비는 것을 볼 수 있습니다.
복셀로 줄이기
disparity map을 얻었다고 모든 픽셀을 다 쓸 필요는 없습니다. 그때도 지금도 쓰는 방법은 이렇습니다.
- disparity map에서 일정한 간격으로 픽셀을 고릅니다. 몇 픽셀에 하나씩만 쓰니 계산할 점이 크게 줄어듭니다.
- 고른 픽셀을 위의 식으로 거리로 바꾸고, 카메라 위치와 방향을 이용해 3D 좌표로 옮깁니다(역투영, back-projection).
- 3D 공간을 일정한 크기의 상자로 나누고, 점이 떨어진 상자에 표시합니다. 이 상자가 복셀(voxel)입니다. 픽셀이 화면의 작은 네모라면, 복셀은 공간의 작은 상자입니다.
- 한 번 찍힌 상자를 바로 장애물로 믿지 않습니다. 여러 프레임에 걸쳐 점이 여러 번 쌓인 상자만 장애물로 봅니다. 잘못 매칭된 점 하나가 오검출(false positive)로 이어지는 걸 막아 줍니다.
- 오래 갱신되지 않은 상자는 지웁니다. 지나간 장애물이 지도에 남지 않게 하기 위해서입니다.
자동차에서는 하나를 더 합니다. 도로 바닥도 카메라에 찍히니, 일정 높이보다 낮은 점은 지면 제거(ground removal)로 걸러 냅니다.
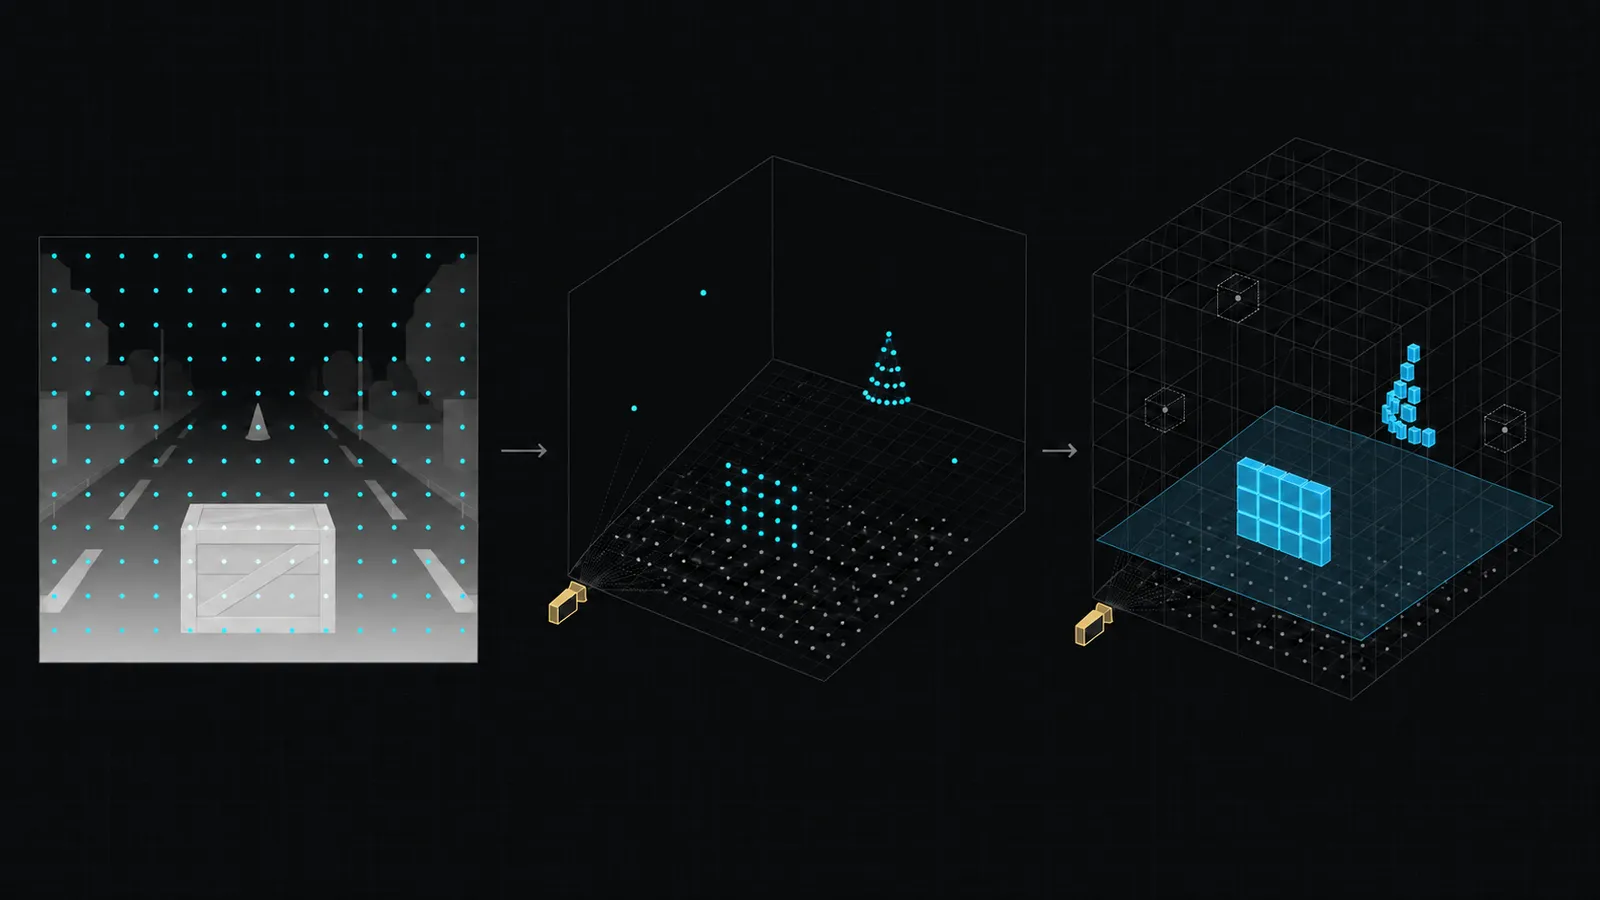
바닥 점과 혼자 떨어진 점은 버린다.
로봇 분야에서는 이렇게 공간을 칸으로 나누고 칸마다 막혔는지 비었는지를 적는 지도를 occupancy grid(점유 격자)라고 부릅니다. 복셀 지도는 그 3D판입니다.
데모에서는 4픽셀마다 한 점을 고르고, 복셀 한 칸은 0.5m입니다. 한 칸에 점이 4개 이상 쌓이면 장애물로 보고, 2.5초 동안 다시 찍히지 않거나 차 뒤로 지나간 칸은 지웁니다. 지면 제거는 0.25m 아래 점을 버리고, 2.6m보다 높은 점과 36m보다 먼 점도 버립니다. 멀리 갈수록 disparity 1픽셀 차이에 거리가 몇 m씩 흔들리기 때문입니다. 샘플 간격과 복셀 기준은 데모의 옵션에서 바꿔 볼 수 있습니다.
피할 방향 고르기
장애물이 어느 칸에 있는지 알았으니, 이제 어느 쪽으로 갈지 정할 차례입니다.
그때 처음 쓴 방법은 potential field였습니다. 목표는 드론을 끌어당기고, 장애물은 드론을 밀어낸다고 보고 두 힘을 합친 방향으로 움직입니다. 단순하고 부드럽지만, 끌어당기는 힘과 밀어내는 힘이 정확히 맞서는 곳(국소 최솟값, local minimum)에 빠지면 그 자리에서 맴도는 약점이 있습니다.
최종적으로는 VFH(Vector Field Histogram)를 3D로 넓힌 방식을 썼습니다. 주변을 방향별 칸으로 나누고, 칸마다 그 방향에 장애물이 얼마나 몰려 있는지 쌓아 히스토그램을 만듭니다. 그다음 장애물이 적은(비어 있는) 방향들 가운데 가고 싶은 방향에 가장 가까운 쪽을 고릅니다. 힘을 더하는 대신 빈 길을 고르는 방식이라 맴도는 문제가 훨씬 적습니다.
이번 자동차는 다시 potential field로 갑니다. 앞으로 계속 달리면서 좌우로만 움직이니, 칸을 골라 핸들을 꺾는 것보다 힘을 합쳐 미끄러지듯 움직이는 쪽이 더 자연스럽습니다. 대신 그때 겪은 약점은 미리 막았습니다.
- 장애물로 판정된 복셀 하나하나가 차를 옆으로 밀어냅니다. 앞으로 가까울수록, 옆으로 가까울수록 세게 밉니다. 차가 내다보는 판단 거리(look-ahead)는 속도에 비례해서, 빠를수록 멀리 봅니다(속도 × 2.2초, 10~36m).
- 도로 양옆에도 보이지 않는 벽을 둡니다. 가장자리에 가까울수록 안쪽으로 세게 밀어서, 장애물에 밀려도 도로 밖으로 나가지 않습니다.
- 정면 한가운데 장애물은 좌우로 미는 힘이 서로 상쇄돼 그대로 들이받기 쉽습니다. 그래서 가장 가까운 장애물에는 옆으로 비껴 미는 힘(와류, vortex)을 더합니다. 장애물이 한쪽으로 치우쳐 있으면 반대쪽으로, 정확히 가운데면 빈 공간이 넓은 쪽으로 돕니다.
- 한 번 정한 쪽은 그 장애물을 지날 때까지 유지합니다(hysteresis). 좌우로 망설이다 부딪히는 일을 막아 줍니다.
- 차 앞 통로에 장애물이 많을수록 최저 속도 쪽으로 속도를 줄이고, 앞이 비면 최고 속도까지 올립니다.
데모 화면의 하늘색 곡선은 이 계산을 앞으로 몇 초 미리 돌려 본 예상 경로입니다. 계산만 따로 떼어 정면 한가운데 상자, 도로 끝 상자, 상자 둘 사이 틈, 연달아 놓인 장애물 같은 경우를 돌려 봤을 때, 망설이거나 들이받지 않았습니다.
직접 플레이
시작을 누르면 AI가 운전을 시작합니다. AI가 보는 것은 아래의 두 카메라 영상뿐이고, 메인 화면의 하늘색 곡선은 AI가 가려는 경로, 하늘색 상자는 장애물로 판정된 복셀입니다.
3D 장면을 불러오는 중입니다스크립트를 켜면 데모가 나옵니다
AI가 보는 것은 이 두 영상뿐입니다. 가까운 물체일수록 두 영상에서 가로로 더 어긋납니다. SGBM 한 번 -
해 볼 만한 것
- 장애물 표면을 민무늬로 바꾸고 카메라 비전을 뎁스로 봅니다. 상자 안쪽이 검게 비고, 판정되는 복셀이 줄어듭니다.
- 카메라 비전을 픽셀로 보면 고른 점과, 그 점이 장애물로 판정됐는지가 보입니다.
- 샘플 간격을 8로 늘리면 쓰는 점이 4픽셀 간격일 때의 4분의 1로 줄어듭니다. 작은 원뿔을 놓치는지 보세요.
- 복셀 기준을 1로 낮추면 잘못 매칭된 점 하나도 바로 장애물이 됩니다.
- 장애물 개수를 많이로, 최고 속도를 올려서 AI를 괴롭혀 봅니다.
정리
오랜만에 회사에서 하던 일을 꺼내 다시 만들어 봤습니다. 카메라 두 대, disparity, 일정 간격 샘플, 복셀, 회피로 이어지는 흐름은 그대로 두고, 무대를 도로로, 계산하는 곳을 브라우저로 옮겼습니다. 고전적인 SGBM은 영상이 작다면 브라우저에서도 한 번에 12ms 남짓이라, 신경망 없이도 실시간으로 충분했습니다.
장애물 표면을 바꿔 가며 30초씩 세 판을 달려 보니, 충돌 횟수는 자연스러운 무늬 2번, 그라데이션 0번, 민무늬 2번이었습니다. 세 판씩이라 횟수로 우열을 말하기는 어렵습니다. 대신 차이는 복셀 수에서 드러났습니다. 민무늬에서는 장애물로 판정된 복셀이 40%쯤 적었습니다. 그래도 상자 가장자리는 배경과 밝기가 달라 짝을 찾을 수 있어서, 작은 상자는 가장자리 복셀만으로도 피했습니다. 민무늬에서 부딪힌 장면 가운데 하나는 3m짜리 가로 막이를 정면으로 만났을 때로, 복셀이 막이 양 끝에만 몇 개 잡혔습니다. 그라데이션은 가로 방향 밝기 변화가 조금이라도 있어서 무늬와 비슷하게 잡혔습니다.
이번 데모에서 카메라만으로 달릴 때 정말 위험했던 건 작은 단색 상자보다 무늬 없는 넓은 면이었습니다. 다음에는 판단 부분을 작은 신경망으로 바꿔서, 지금의 계산식 AI와 누가 더 멀리 가는지 겨뤄 보고 싶습니다.
용어 설명
글에서는 기술 용어를 원어로 쓰고, 우리말로 옮길 수 있는 말은 괄호에 함께 적었습니다. 처음 보는 말이 있으면 여기서 찾아보세요.
카메라와 거리
- stereo depth: 나란히 놓인 카메라 두 대의 영상으로 거리를 구하는 방법. 사람의 두 눈과 같은 원리입니다.
- disparity(시차): 같은 물체가 왼쪽 영상과 오른쪽 영상에서 가로로 어긋난 정도(픽셀). 가까울수록 크고, 멀수록 작습니다.
- focal length(초점 거리): 카메라의 초점 거리. 거리 계산에서는 픽셀 단위로 씁니다.
- baseline(기선): 두 카메라 사이의 간격. 넓을수록 먼 곳의 거리를 더 정확히 재지만, 가까운 물체는 한쪽 카메라에만 보이기 쉽습니다.
- rectification(정류): 두 영상의 같은 점이 같은 가로줄에 오도록 영상을 바로잡는 일. 이 글의 가상 카메라는 처음부터 나란해서 필요 없습니다.
- stereo matching(스테레오 정합): 왼쪽 영상의 한 점이 오른쪽 영상의 어디에 찍혔는지 찾는 일.
- matching cost / penalty(정합 비용 / 페널티): 매칭에서 두 블록이 얼마나 다른지 매긴 점수와, 이웃 픽셀끼리 disparity가 갑자기 튈 때 더하는 점수.
- depth map / disparity map(깊이 지도 / 시차 지도): 영상의 픽셀마다 거리(depth)나 disparity를 적어 둔 지도.
- relative depth / metric depth(상대 깊이 / 절대 깊이): 무엇이 더 가깝고 먼지만 아는 깊이(relative)와, 몇 미터인지까지 아는 깊이(metric).
- textureless(텍스처 없는 영역): 하얀 벽처럼 민무늬라서 매칭할 단서가 없는 면.
- occlusion(폐색 영역): 한쪽 카메라에는 보이는데 다른 쪽에서는 앞의 물체에 가려 안 보이는 부분.
계산식과 신경망
- SGM / SGBM: Semi-Global Matching. 영상 전체를 한 번에 최적화(global)하는 대신, 여러 방향의 직선 경로를 따라 비용을 모아 푸는 stereo matching 방법. SGBM은 블록 단위로 비교하는 OpenCV의 변형입니다.
- SAD: 두 블록의 같은 자리 픽셀끼리 밝기 차를 절댓값으로 더하거나 평균한 값. 작을수록 두 블록이 비슷합니다.
- uniqueness ratio: 가장 좋은 후보의 비용이 다른 후보와 거의 같으면 믿지 않고 버리는 기준.
- texture threshold: 블록 안에 밝기 변화가 너무 적으면 매칭을 포기하고 비워 두는 기준.
- Mutual Information(상호정보량): 두 영상의 밝기가 서로 얼마나 정보를 공유하는지 재는 값. 원래 SGM이 비용으로 썼습니다.
- WLS 필터: Weighted Least Squares(가중 최소제곱). 원본 영상의 경계를 따라 값을 매끄럽게 채우는 필터로, disparity map의 구멍과 잡음을 다듬는 데 씁니다.
- left-right consistency(좌우 일관성 검사): 왼쪽 기준과 오른쪽 기준으로 각각 구한 disparity가 서로 맞는지 대조해, 믿을 만한 값만 남기는 검사.
- optical flow(광류): 연속된 두 영상 사이에서 픽셀마다 어디로 움직였는지 구한 것.
- feature(특징): 신경망이 영상에서 뽑아낸 특징 값.
- correlation volume(상관 볼륨): 두 영상의 feature를 모든 disparity 후보마다 미리 비교해 쌓아 둔 표.
- GRU: Gated Recurrent Unit. 이전 결과를 기억하며 같은 계산을 반복하는 신경망 부품. RAFT-Stereo는 이걸로 disparity map을 여러 번 고쳐 씁니다.
- coarse-to-fine: 낮은 해상도에서 대충 맞춘 뒤 높은 해상도로 올라가며 다듬는 방식.
- Web Worker: 화면을 그리는 흐름과 따로 계산을 돌리는 브라우저 기능. 무거운 계산을 해도 화면이 멈추지 않습니다.
- fine-tuning(미세조정): 이미 학습된 모델을 새 데이터로 조금 더 학습시켜 맞추는 일.
장애물과 회피
- back-projection(역투영): 영상 속 픽셀과 그 거리로 3D 공간의 점 위치를 되짚어 구하는 계산.
- voxel(복셀): 3D 공간을 같은 크기로 나눈 작은 상자 하나. 픽셀의 3D판입니다.
- false positive(오검출): 없는 것을 있다고 잘못 판단한 결과. 여기서는 잘못 매칭된 점 때문에 없는 장애물을 있다고 보는 경우.
- ground removal(지면 제거): 바닥에 찍힌 점을 장애물로 오해하지 않게 걸러 내는 처리.
- occupancy grid(점유 격자): 공간을 칸으로 나누고 칸마다 막혔는지 비었는지 적어 둔 지도.
- potential field: 목표는 끌어당기고 장애물은 밀어내는 가상의 힘을 합쳐 움직일 방향을 정하는 방법.
- local minimum(국소 최솟값): 힘이 서로 상쇄되어 목표가 아닌데도 멈춰 버리는 자리. potential field의 대표적인 약점입니다.
- look-ahead(판단 거리): 회피를 판단할 때 앞으로 얼마나 멀리까지 보는지. 이 데모에서는 속도에 비례합니다.
- vortex(와류): 장애물 둘레를 돌아가도록 옆으로 비껴 미는 힘. potential field가 정면 장애물 앞에서 멈추는 문제를 막습니다.
- hysteresis: 한 번 정한 쪽을 쉽게 바꾸지 않게 하는 장치. 좌우로 망설이는 떨림을 막습니다.
- VFH: Vector Field Histogram. 주변을 방향별 칸으로 나눠 장애물이 얼마나 몰려 있는지 히스토그램으로 쌓고, 비어 있는 방향 중 목표에 가까운 쪽을 고르는 방법.
- field of view(화각): 카메라 한 대가 한 번에 담는 범위의 각도.
- ADAS(첨단 운전자 보조 시스템): 차선 유지, 앞차 따라가기, 긴급 제동처럼 운전을 돕는 장치를 묶어 부르는 말.
- LiDAR(라이다): 레이저를 쏘아 반사되어 돌아오는 시간으로 거리를 재는 센서.
더 알아보기
스테레오 기초
- Middlebury Stereo: stereo matching 알고리즘을 같은 데이터로 비교하는 대표 평가 사이트
- OpenCV: Depth Map from Stereo Images: disparity와 거리 공식, 간단한 예제
거리 계산
- SGM 원 논문: H. Hirschmüller, Stereo Processing by Semiglobal Matching and Mutual Information, IEEE TPAMI, 2008
- OpenCV StereoSGBM 문서: 원 논문과 다른 점, 설정값
- OpenCV disparity map post-filtering(WLS) 튜토리얼, 바탕 논문: D. Min 외, Fast Global Image Smoothing Based on Weighted Least Squares, IEEE TIP, 2014
- RAFT-Stereo: 논문(3DV 2021) · 코드
- CREStereo: 논문(CVPR 2022) · 코드
- Depth Anything V2: 논문(NeurIPS 2024) · 코드
장애물 지도
- Occupancy grid: A. Elfes, Using Occupancy Grids for Mobile Robot Perception and Navigation, IEEE Computer, 1989
- OctoMap: 3D occupancy map을 octree로 가볍게 담는 라이브러리
피할 방향
- Potential field: O. Khatib, Real-Time Obstacle Avoidance for Manipulators and Mobile Robots, IJRR, 1986
- VFH: J. Borenstein, Y. Koren, The Vector Field Histogram: Fast Obstacle Avoidance for Mobile Robots, IEEE Transactions on Robotics and Automation, 1991
- VFH의 3D 확장: S. Vanneste 외, 3DVFH+: Real-Time Three-Dimensional Obstacle Avoidance Using an Octomap, 2014
- PX4-Avoidance: 드론 오픈소스 PX4의 3DVFH+ 기반 회피 코드(2024년부터 보관 상태)
데모
- three.js: 데모의 3D 화면을 그린 WebGL 라이브러리
- MDN: Web Workers API: 화면과 따로 계산을 돌리는 방법
자동차와 카메라
- TechCrunch: "Anyone relying on lidar is doomed," Elon Musk says (2019)
- Subaru EyeSight: 두 카메라로 앞길을 보는 운전 보조 장치

COMMENTS
댓글을 불러오고 있습니다.